
Context Layer #2: Evals, Evals, Evals
זהו חלק 2 בסדרה הטכנית על Context Layers עבור AI Agents. אם עניין אותך לקרוא את המאמר הראשון, התחל מחלק 1: מה זה Context Layer ולמה אתה חייב כזה.
מה זה בעצם אומר "אפקטיבי"?
בחלק הראשון של הסדרה, הגדרנו שכל AI Agent הוא בסופו של דבר execution loop המעבירה נתונים לצינורות של כפל מטריצות. הגורם המבדל בין Prototype שביר לבין מערכת Production אינו ה-Syntax של ה-Framework: אלא האיכות והמבנה של ה-Data שאתה מספק.
זה מוביל אותנו לאתגר המרכזי של חלק 2. כדי לבנות Context Layer אפקטיבי, אנחנו חייבים להתחיל מהשאלה החשובה ביותר בהנדסת AI: איך אנחנו מזהים מה באמת אפקטיבי?
נחזור לתרחיש העוגן שלנו: לבקש מסייען AI לשלוח מייל תודה לנהוראי על מתנת יום ההולדת שלו. לפני שכותבים שורת קוד אחת של הרכבת Context, חייבים להעריך איך נראים הצלחה וכישלון בדומיין הספציפי שלך:
- מה קורה אם ה-Agent שולח את המייל לנהוראי הלא נכון?
- מה קורה אם הוא מודה על ספל קפה כאשר הוא בעצם הביאה בלנדר?
- מה קורה אם הוא משתמש ב-Tone הלא נכון?
למוצרים שונים יש סדר עדיפויות שונה לחלוטין:
- הגישה הקפדנית של Directory Strict: עבור אפליקציית HR ארגונית, זיהוי נהוראי הנכון (נהוראי מניהול מול נהוראי המתמחה) הוא בסדר עדיפויות עליון. נמען שגוי הוא דליפת אבטחה חמורה.
- גישת Human In The Loop: עבור כלי לסייען ניהולי, יצירת טיוטה עם מזהה נמען שגוי היא נסבלת כי המשתמש מאמת בקלות את הנמען לפני השליחה. מה שבאמת חשוב בהחלטה הזו הוא דיוק ה-Data: ה-Context Layer חייב לשלוף את הפרטים העובדתיים המדויקים (אזכור הבלנדר המקורי מהקבלה) מבלי להזות עובדות (כמו להודות על ספל קפה שהוא מעולם לא קנה).
- גישת Tone First: עבור אפליקציה המבוססת על אישיות, העדיפות העליונה עשויה להיות ה-Tone הפסיבי אגרסיבי של ההודעה. מייל התודה צריך לפגוע ב-Tone הסיינפלדי המדויק ("תודה על המתנה, אשתדל למצוא לזה פינה בארון בסופו של דבר.") כדי שנהוראי יבין שהמתנה בסדר, אבל לא מעבר.
לפני שבונים פיצ'רים של Context, חייבים להעריך: אילו פונקציות קריטיות המערכת שלך חייבת לבצע בצורה מעולה, אילו פונקציות יכולות להיות רק בסדר, ואיפה אפשר להשלים עם פשרות?
פילוסופיית "Evals, Evals, Evals"
אם סטיב באלמר היה מעביר כיום הרצאה מרכזית על הנדסת AI Agents, הוא לא היה צועק "Developers, developers, developers!". הוא היה מזיע דרך החולצה שלו וצועק מילה אחת: Evals! Evals! Evals!
בניית Context Layer ללא מערך Evaluation היא כמו ניווט ספינה ללא מצפן. אתה תבלה שבועות בבניית צינורות Graph RAG מורכבים או טריקים של Vector Retrieval מבלי לדעת אם באמת שיפרת את המערכת או הכנסת רגרסיות שקטות. הערכה (Evaluation) היא עולם שלם, אבל כשבונים Context Layers עבור Agents, הבדיקות מתחלקות לארבע רמות מעשיות.
4 הרמות של הערכת Agents ו-Context
אנחנו לא הולכים לבזבז כאן זמן על דיונים תיאורטיים במדדים בסיסיים כמו Precision ו-Recall או מושגי יסוד שכל אחד מכיר. במקום זאת, המטרה של הסעיף הזה היא להנחות אותך בפרקטיקה ההנדסית הממשית: מה הדברים הספציפיים והמעשיים שאתה באמת חייב לבדוק (מבנה ה-Payload, התנהגות ה-Trace, ומכניקת ה-Context) כדי לוודא שאיכות ה-Context Layer שלך עובדת ב-Production.
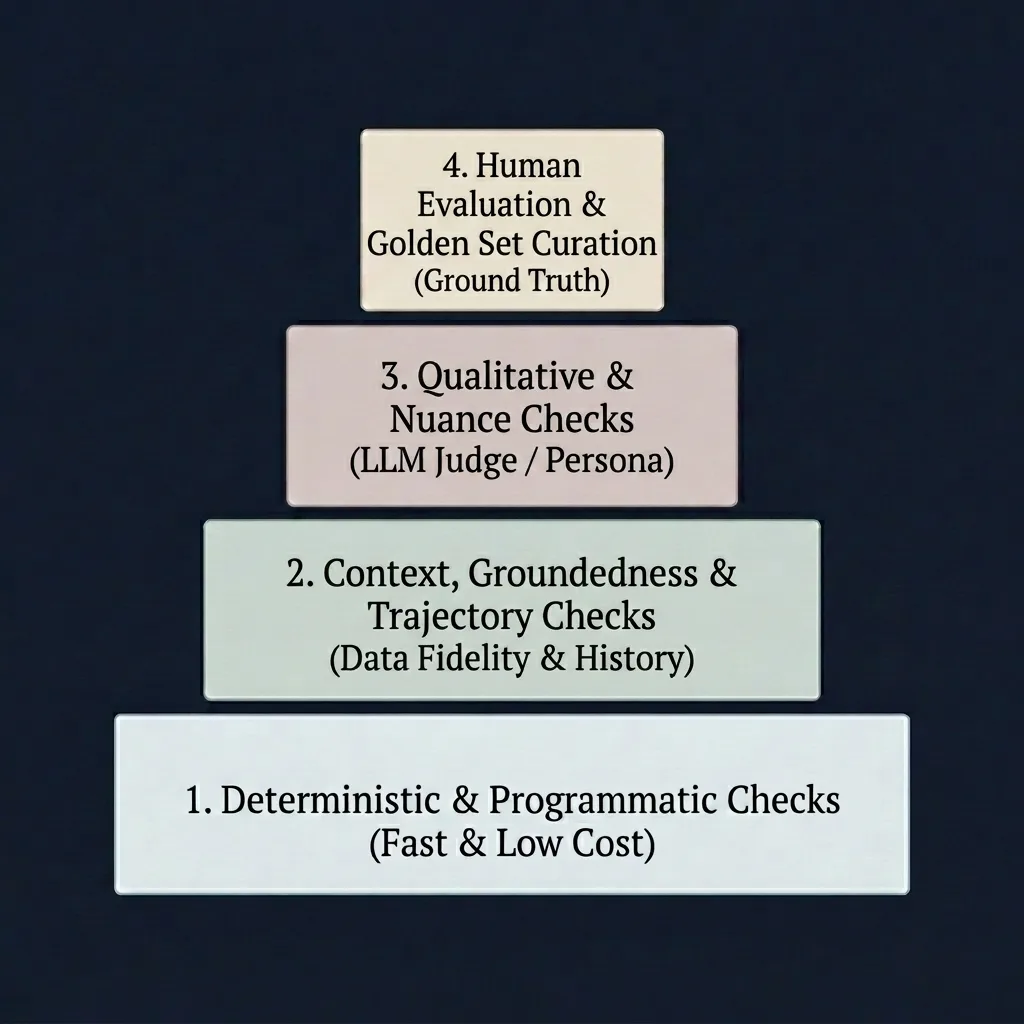
רמה 1: בדיקות דטרמיניסטיות ותכנותיות (Functional and Execution)
בדיקות ברמה 1 מתמקדות אך ורק במכניקת הביצוע. האם המערכת ביצעה את הפעולה המבוקשת מבלי לזרוק שגיאות או להפר מגבלות פורמט?
הבדיקות המרכזיות כוללות:
- תקינות Payload ו-Syntax: האם המודל הפיק JSON תקין התואם ל-Schema המבוקש?
- קריאה ל-Tools (Tool Invocation): האם המערכת הפעילה את כלי היעד או עדכנה את מצב ה-Database?
- מגבלות בטיחות ו-PII: האם המערכת נמנעה מדליפת מידע רגיש או מפעולות מחוץ לתחום?
התרחיש של נהוראי: האם ה-Agent חיפש ב-Directory, מצא רשומה, ובנה Payload תקין של מייל מבלי לקרוס? בדיקה זו מאמתת שהמערכת רצה, אך היא אינה אומרת אם היא עשתה את הדבר הנכון.
from pydantic import BaseModel, EmailStr

class EmailPayload(BaseModel):
    recipient_email: EmailStr
    subject: str
    body: str

# Tool Execution Sequence
def assert_tool_sequence(agent_trace: list[dict], required_tools: list[str]):
    called_tools = [s.get("tool") for s in agent_trace if "tool" in s]
    for tool in required_tools:
        assert tool in called_tools, f"Missing required tool call: '{tool}'"

# Output Schema Validation
def assert_output_schema(agent_output: dict) -> EmailPayload:
    return EmailPayload(**agent_output)

# PII Leak Prevention
def assert_no_pii_leak(body_text: str, blocked_fields: list[str]):
    body_lower = body_text.lower()
    for field in blocked_fields:
        assert field not in body_lower, f"PII Leak: '{field}' detected in body"
רמה 2: בדיקות הקשר ונאמנות (Data Fidelity ו-RAG Triad)
בדיקות ברמה 2 מעריכות את דיוק המידע ומניעת הזיות (Hallucinations) באמצעות עקרונות מתוך ה-RAG Triad:
- Retrieved Relevance: האם ה-Context Layer שלף מידע שבאמת מכיל את הפרטים הנדרשים לפעולה?
- Groundedness / Faithfulness: האם כל טענה בתשובה נשענת strictly על ה-Context שנשלף?
- Answer Relevance: האם הפלט מענה ישירות לכוונה של המשתמש מבלי להוסיף רעש לא רלוונטי?
התרחיש של נהוראי: האם המערכת חילצה את קבלת הקנייה המקורית עבור הבלנדר, או שהיא המציאה סיפור על ספל קפה שלא הוזכר כלל בהקשר?
from pydantic import BaseModel

class StructuredDraft(BaseModel):
    body: str
    referenced_item: str

# Retrieved Relevance
def assert_retrieval_relevance(retrieved_docs: list[dict]):
    assert len(retrieved_docs) > 0, "Retrieval miss: no documents fetched"

# Groundedness via Structured Output
def assert_groundedness(referenced_item: str, retrieved_docs: list[dict]):
    doc_text = " ".join(d.get("content", "") for d in retrieved_docs).lower()
    assert "blender" in referenced_item.lower(), \
        f"Incorrect item referenced: '{referenced_item}' (expected blender)"
    assert referenced_item.lower() in doc_text, \
        f"Ungrounded claim: '{referenced_item}' not supported by retrieved docs"

# Answer Relevance
def assert_answer_relevance(draft_body: str):
    body_lower = draft_body.lower()
    assert any(token in body_lower for token in ["thank", "appreciation", "grateful"]), \
        "Off-topic: draft does not fulfill gratitude intent"
רמה 3: בדיקות מסלול ולוגיקה (Execution History)
בדיקות ברמה 3 בוחנות איך ה-Agent הגיע להחלטה שלו על ידי ניתוח ה-Trace Logs וצעדי החשיבה שבדרך:
- Entity Selection Accuracy: האם המערכת מיפתה פרמטרים עמומים לישות הנכונה בעולם האמיתי?
- Step Efficiency: האם ה-Agent פתר את המשימה ב-2 צעדים לוגיים, או שהוא נכנס ללולאה של 10 צעדים עם קריאות API כפולות?
- Reasoning Coherence: האם כל פעולת ביניים נובעת לוגית מהמצב של הצעד הקודם?
התרחיש של נהוראי: האם המערכת בחרה בנהוראי מניהול על בסיס היסטוריית המיילים, או שהיא בחרה בנהוראי המתמחה בגלל שהיא התעלמה מרמזי ה-Context?
# Step Efficiency and Duplicate Loop Detection
def assert_step_efficiency(tool_calls: list[dict], max_allowed: int = 5):
    assert len(tool_calls) <= max_allowed, \
        f"Inefficient: executed {len(tool_calls)} steps (max {max_allowed})"
    seen_calls = set()
    for call in tool_calls:
        signature = (call.get("tool"), str(call.get("args")))
        assert signature not in seen_calls, \
            f"Redundant loop: duplicate call to {signature[0]}"
        seen_calls.add(signature)

# Entity Selection Accuracy
def assert_entity_selection(tool_calls: list[dict], expected_recipient_id: str):
    send_step = next((s for s in tool_calls if s.get("tool") == "SendEmail"), None)
    assert send_step is not None, "Missing action: SendEmail tool never called"
    selected_id = send_step.get("args", {}).get("recipient_id")
    assert selected_id == expected_recipient_id, \
        f"Entity error: selected '{selected_id}', expected '{expected_recipient_id}'"

# Reasoning Coherence and Tool Order
def assert_reasoning_coherence(tool_calls: list[dict]):
    tool_names = [s.get("tool") for s in tool_calls]
    assert "SearchDirectory" in tool_names, "Incoherent: directory search missing"
    assert tool_names.index("SearchDirectory") < tool_names.index("SendEmail"), \
        "Incoherent: email sent before searching directory"
רמה 4: בדיקות איכות וטון (LLM as a Judge)
בדיקות ברמה 4 מעריכות איכות סובייקטיבית, התאמת Tone ועמידה בסגנון כתיבה שלא ניתן לאמת באמצעות בדיקות קוד דטרמיניסטיות:
- Tone and Persona Alignment: האם סגנון הכתיבה מתאים ל-Persona הספציפית של המשתמש (כגון הומור יבש)?
- Authorship Authenticity (אותנטיות הכותב): האם הטיוטה נשמעת באמת כמו משהו שאני כתבתי, בהתאמה לדוגמאות כתיבה אמיתיות שלי ולא לטקסט גנרי של AI?
- הערכת ניואנסים סובייקטיביים: האם הפלט מכבד גבולות סגנון משתמעים (הימנעות מניסוחים נלהבים מדי)?
התרחיש של נהוראי: פרופיל ה-Persona של המשתמש מציין שהוא מתקשר בהומור יבש. האם המייל פגע ברמת ה-Tone המבוקשת ונשמע כמו משהו שהמשתמש כתב, או שהמודל הפיק תודה נלהבת וגנרית שסותרת את הקול האמיתי של המשתמש?
import json
from openai import OpenAI

client = OpenAI()

# Qualitative Tone and Persona Alignment (LLM-as-a-Judge)
def assert_persona_tone(draft_text: str, target_persona: str) -> dict:
    sys_prompt = (
        f"The user's communication style is: {target_persona}.\n"
        "Rate how well this draft matches that style.\n"
        "Score 1-5: 1=completely wrong tone, 5=perfect match.\n"
        'Return JSON: {"score": int, "reasoning": str}'
    )
    response = client.chat.completions.create(
        model="gpt-4o",
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": sys_prompt},
            {"role": "user", "content": draft_text}
        ]
    )
    result = json.loads(response.choices[0].message.content)
    assert result["score"] >= 4, f"Tone mismatch ({result['score']}/5): {result['reasoning']}"
    return result

# Authorship Authenticity Check (Voice Fingerprint Match)
def assert_authorship_authenticity(draft_text: str, writing_samples: list[str]) -> dict:
    samples_block = "\n---\n".join(writing_samples)
    sys_prompt = (
        "Compare the draft email against these authentic writing samples from the user:\n"
        f"{samples_block}\n"
        "Evaluate if the draft sounds genuinely like something this specific person wrote.\n"
        "Score 1-5: 1=generic AI tone, 5=indistinguishable from the author's voice.\n"
        'Return JSON: {"score": int, "reasoning": str}'
    )
    response = client.chat.completions.create(
        model="gpt-4o",
        response_format={"type": "json_object"},
        messages=[
            {"role": "system", "content": sys_prompt},
            {"role": "user", "content": draft_text}
        ]
    )
    result = json.loads(response.choices[0].message.content)
    assert result["score"] >= 4, f"Authenticity failure ({result['score']}/5): {result['reasoning']}"
    return result
מטריצת סיכום ההערכה
חיבור כל ארבע הרמות יחד עבור תרחיש המייל לנהוראי יוצר מטריצת Evaluation שלמה:
| Tier | מה נבדק? | שאלת הבדיקה בתרחיש של נהוראי |
|---|---|---|
| Tier 1 (Execution) | Tool Sequence, Schema, PII | האם ה-Agent הפעיל SearchDirectory ואז SendEmail עם Payload תקין וללא דליפת PII? |
| Tier 2 (Context) | Retrieved Relevance, Groundedness | האם ה-Draft מזכיר את הבלנדר מתוך הקבלה שנשלפה, ללא פריטים שהומצאו? |
| Tier 3 (Trajectory) | Entity Selection, Step Count, Order | האם ה-Trace אישר שנהוראי מניהול נבחר, מתחת ל-5 צעדים, עם Search לפני Send? |
| Tier 4 (Qualitative) | Tone, Persona, Constraints | האם ה-Tone תאם את ה-Persona הפסיבית אגרסיבית של המשתמש, ומתחת ל-3 משפטים? |
מלכודות ואסטרטגיות מתקדמות: מה עוד אפשר לעשות?
4 הרמות שתיארנו הן נקודת ההתחלה, לא הסוף. יש עשרות גישות Evaluation נוספות שעובדות טוב יותר או גרוע יותר בהתאם לדומיין שלך. יש צוותים שמדלגים על כל מה שתואר למעלה ומסתמכים אך ורק על A/B Testing מול משתמשים חיים: לחכות לפידבק שלילי ב-Production היא הגישה העצלנית והמסוכנת ביותר, אבל היא קיימת כשהמערכת חסרה בדיקות אוטומטיות.
ככל שה-Context Layer שלך גדל ב-Production, תיתקל בארבע מלכודות Evals נפוצות:
flowchart TD
    TRAP["Evals Pitfalls"] --> P1["1. Single-Run Flakiness
(אקראיות של LLM בדיקות CI)"]
    TRAP --> P2["2. הטיות של LLM-as-a-Judge
(העדפת מודלים מאותה משפחה)"]
    TRAP --> P3["3. עיוורון לעלויות ו-Latency
(ריצה של 12 שניות בעלות $0.40)"]
    TRAP --> P4["4. Output-Only Myopia
(התעלמות מכשלי שליפת Context)"]
1. מלכודת הריצה הבודדת (Single-Run Flakiness)
בגלל ש-LLMs הם אינם דטרמיניסטיים, הרצת סבב בדיקה בודד בצינור ה-CI/CD מעניקה תחושת ביטחון מוטעית. Agent עשוי לעבור בדיקת מסלול ברמה 3 בפעם אחת מתוך 5 בגלל מזל בלבד. חייבים להריץ Evals לאורך מספר איטרציות כדי למדוד אחוזי מעבר סטטיסטיים.
2. הטיית LLM-as-a-Judge
כאשר משתמשים במודלים כמו gpt-4o כדי לשפוט פלטים ברמה 4, המעריכים מציגים הטיות שיטתיות: העדפת תשובות ארוכות, מתן ציון גבוה לפלטים מזהים של אותה משפחת מודלים, או המצאת נימוקים לציון.
3. התעלמות מעלות, Latency ויעילות Tokens
נכונות היא רק מחצית מהמשוואה. אם ה-Context Layer שלך שולף 50,000 Tokens של היסטוריה גולמית, לוקח 12 שניות ועולה $0.40 לכל הרצה רק כדי לשלוח מייל תודה פשוט לנהוראי, הארכיטקטורה שלך שבורה ב-Production.
4. הערכת הפלט בלבד (Output-Only Myopia)
בדיקת המייל הסופי בלבד מסווה את הסיבה לכישלון. האם זה היה כשל שליפה (ה-Context Layer שלף את נהוראי הלא נכון), כשל דחיסת Context (נתונים הושמטו), או כשל במעקב אחר הנחיות (ה-LLM התעלם מהמידע שנשלף)?
מאיפה מתחילים? פיתוח מונחה Benchmark Simulation
עכשיו כשאתה יודע איך לבדוק את המערכת שלך, איך מחליטים מה לבנות קודם? בדיוק כמו בכל פיתוח תוכנה ב-Production, מתחילים עם Benchmark Simulation Driven Development:
- אוספים נתוני אמת: מגבשים Dataset ריאליסטי של אינטראקציות Production או בדיקות משתמשים.
- מריצים הערכת בסיס (Baseline): מריצים את המערכת הנוכחית מול ה-Benchmark ומקבלים ניקוד בסיסי בכל ארבע הרמות.
- מתעדפים צווארי בקבוק: מזהים באיזו רמה מתקבל הניקוד הנמוך ביותר או הסיכון הגבוה ביותר עבור יעדי המוצר שלך.
לפני שכותבים קוד עבור פיצ'ר Context חדש, אתה חייב להיות מסוגל להגיד:
אם אני אבנה את כלי ה-Entity Resolution הספציפי הזה, ניקוד ה-Trajectory Accuracy שלנו יעלה ב-30%.
אם אתה לא יכול להגיד את המשפט הזה כשהוא מגובה בנתוני Evaluation, אתה מבזבז את זמן הפיתוח שלך על תשתיות שלא הוכחו.
Offline Evals מול ניטור בזמן אמת ב-Online
הערכה ב-Offline בזמן פיתוח וב-CI/CD היא חיונית, אך הערכת Offline בלבד אינה מספיקה. חייבים לבצע הערכה רציפה גם ב-Online במערכת הייצור.
בדיקות Offline מאמתות את הנחות היסוד לפני העלאת הקוד. ניטור Online מפקח על Prompts של משתמשים אמיתיים, מזהה קפיצות ב-Latency, מגלה סטיות שליפה, ולוכד פידבק משתמשים בזמן אמת.
לצלילה עמוקה למסגרות הערכה ב-Production ו-Online Observability, מומלץ לקרוא את המדריכים הבאים:
מה הצעד הבא?
ברגע שבנית את מערך ה-Evaluation שלך וזיהית את צווארי הבקבוק המרכזיים, אתה מוכן לבנות Context Abstractions שמשנות באופן ישיר את התוצאות.
ב-חלק 3: ארכיטקטורת 4 השכבות של ה-Context Layer, נצלול לארכיטקטורת התשתית המלאה ונבין איך לבנות Data Layer רב-שכבתי עבור AI Agents.
Context Layer
הירשמו לעדכונים על מאמרים חדשים
קבלו הודעה ישירות לתיבת הדוא"ל בכל פעם שמתפרסם ניתוח מוזיקלי או פרויקט AI חדש.
פרויקטים נוספים שאולי תאהבו
איך אני עובד עם AI בפיתוח תוכנה
פיתוח תוכנה עם AI הוא לא להאציל משימות לפרומפט. הוא עוסק בהסטת הפוקוס מכתיבת סינטקס למפרטים מפורטים, קריאת קוד, Context Layer ולולאות משוב מהירות.
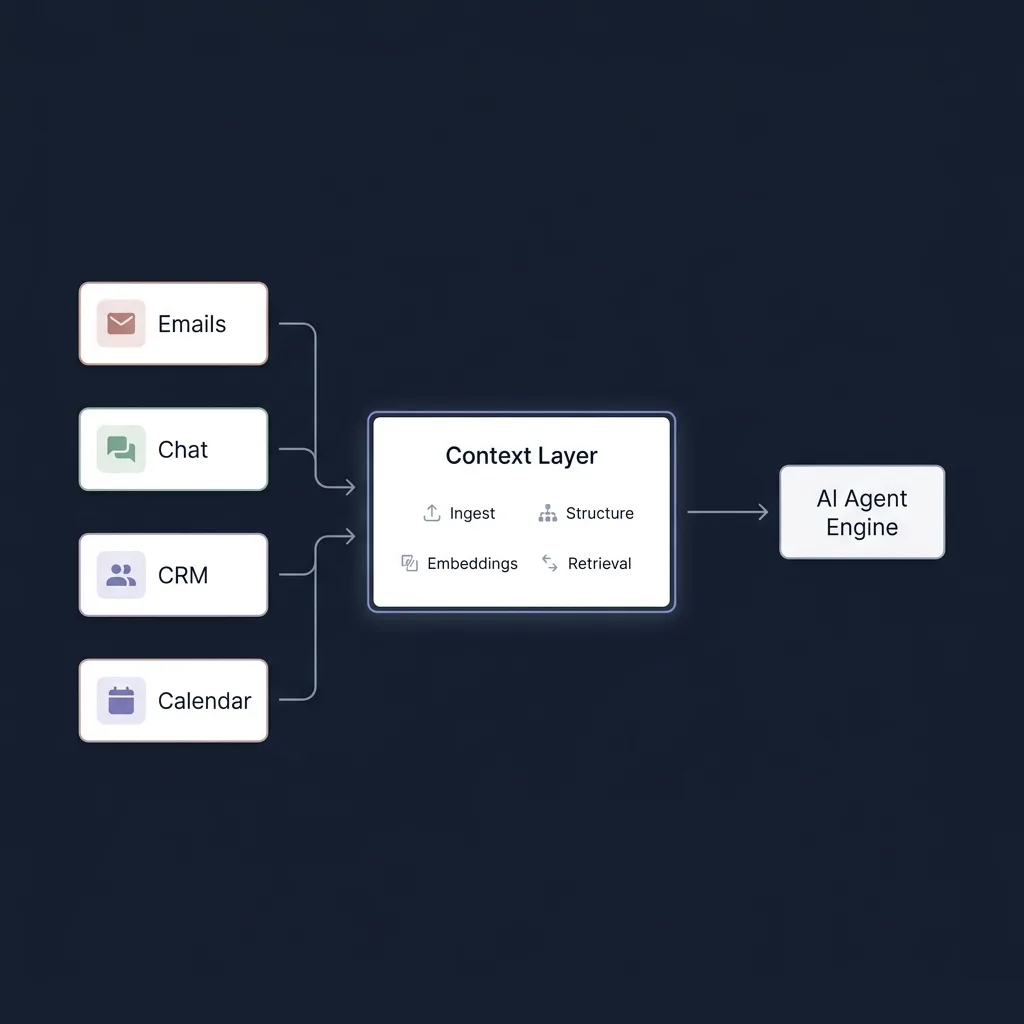
Context Layer #1: למה ה-Agent שלך נכשל
בבסיסם, AI Agents הם פשוט לולאת LLM העטופה ב-Context וב-Tools. גלה למה ה-Context Layer הוא צוואר הבקבוק האמיתי של ביצועי Agent, ולמה איכות ה-Context חשובה בהרבה מ-Planning אוטונומי.
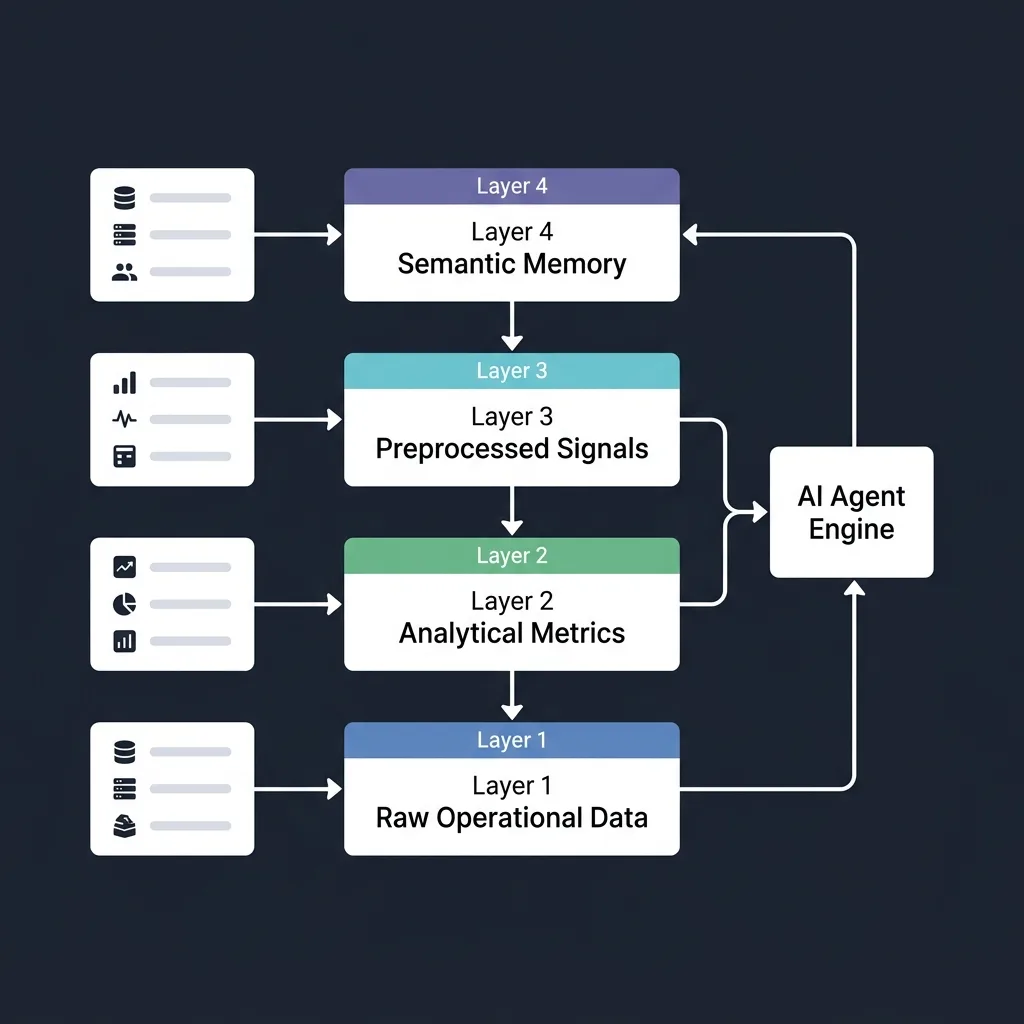
Context Layer #3: ארכיטקטורת 4 השכבות
איך לבנות Context Layer ב-4 שכבות פונקציונליות מול תרחיש CRM מציאותי: נתונים גולמיים, מטריקות אנליטיות, אותות מעובדים מראש וזיכרון סמנטי.