
איך אני עובד עם AI בפיתוח תוכנה
בשבוע שעבר בניתי אפליקציה חדשה מאפס. אבל בפעם הראשונה מזה שנתיים, זה לא הרגיש כמו מאבק מול תיבת פרומפטים בלתי צפויה: זה הרגיש כמו לבנות תוכנה בדרך שנכונה לעשות זאת.
להגיע לנקודה הזו לקח הרבה ניסוי וטעות כואבים. במהלך השנתיים האחרונות ניסיתי את Claude Code, Codex, Cursor וכל כלי AI חדש שהתפוצץ ב-Twitter וב-LinkedIn. כל מומחה מטעם עצמו בפיד שלי פרסם שרשור שטען שהוא פיצח את הסוד לפרודוקטיביות פי 10.
נפלתי בכל מלכודת אפשרית: סמכתי על הזיות של AI, נתקעתי מול ספינרים בלתי נגמרים, עשיתי context switching עד שהמוח שלי נשרף, והתעוררתי לקודבייסים בלתי אפשריים לתחזוקה שבקושי הבנתי. בניתי לא מעט פרויקטים גרועים בדרך.
אני לא כאן כדי להיות עוד משיח טכנולוגי שמבקש מכם להגיב בפוסט כדי לקבל קורס חינמי או קובץ PDF. אני לא טוען שפתרתי את הנדסת התוכנה או פיצחתי קסם אוניברסלי. אבל אחרי שנתיים של ניסוי וטעות, תיעדתי את המודלים המחשבתיים המדויקים שעובדים עבורי ב-production.
הבעיות המרכזיות עם AI בפיתוח תוכנה
לפני שנצלול למערכת שפתרה את יום העבודה שלי, כדאי לפרק את שלוש הבעיות המרכזיות שהמשיכו להרוס לי את הפרויקטים בהתחלה:
1. כמעט נכון זה לא מספיק טוב
במקרים רבים, לעשות debugging לקוד שנוצר על ידי AI לוקח יותר זמן מאשר כתיבתו מאפס. Refactoring הופך לכואב, והבנת הלוגיקה, במיוחד כשהיא ספציפית ל-domain, הופכת לקשה עוד יותר. ככל שאתה מתרחק מהלוגיקה של עצמך, ככה קשה יותר לסמוך על הקוד.
AI יכול ליצור קוד שהוא כמעט נכון. הוא מגיע קרוב, לעיתים בצורה מרשימה, אבל לעיתים נדירות פוגע בכוונה המלאה. התוצר לעיתים קרובות חסר היצמדות לעקרונות של clean code, או שהוא מפרש לא נכון את הדרישות. הוא עשוי לעבוד, אבל לא בדרך שקל לתחזק אותה.
AI מצוין בלהביא אותך ל-80 אחוז. אבל כשאתה נותן לו יותר מדי שליטה, המעבר מ-80 אחוז ל-100 אחוז הופך לאיטי ומתסכל יותר מאשר ביצוע כל המשימה בעצמך.
2. התהליך מרגיש איטי ומנותק
אחת הבעיות הסמויות היא שה-workflow הופך למקוטע. אתה מחכה. אתה לבוהה בספינר של טעינה. כמה זמן תיקח התשובה? בינתיים, אתה לא עושה כלום או מנסה לעשות context switching למשימה אחרת.
אנשים מסוימים מתמודדים עם זה על ידי מולטי-טסקינג וג'אגלינג בין כמה טיקטים במקביל. באופן אישי, גיליתי ש-context switching הופך אותי לפחות פרודוקטיבי. אני מאבד פוקוס, מתפזר מנטלית, ומדלג בין רעיונות חצי אפויים. לולאת המשוב איטית ועמומה, ושוחקת בהדרגה את המומנטום שלך.
3. אתה מאבד מגע עם הקודבייס שלך
זה היה החלק הכי פחות צפוי עבורי. כשאתה מסתמך יותר מדי על AI, אתה מפסיק בהדרגה להיות המחבר של הקוד שלך; אתה הופך ל-reviewer. והמרחק הזה משמעותי.
כשאתה עושה review לקוד של מישהו אחר (או של AI), אתה לא רואה את ההחלטות, השבילים שנזנחו, וה-tradeoffs. אתה רואה רק את התוצאה הסופית. זה עובד מצוין עבור utilities בודדים, אבל כשאתה בונה מערכות מורכבות עם לוגיקה עמוקה, ההפרדה הזו הופכת למסוכנת.
אתה מפסיק להבין את המערכת של עצמך. אתה מפסיק לראות את הקצוות שבהם דברים יכולים להישבר. וכשהם נשברים, אין לך את הכלים לתקן אותם.
השיעורים שלמדתי
ההבנה של המלכודות האלו הכריחה אותי לחשוב מחדש על כל תהליך הפיתוח שלי. הנה ששת עקרונות הליבה שתיקנו את ה-workflow שלי ואפשרו לי לבנות תוכנה בצורה אפקטיבית:
1. להתמקד רק במה שעולה הרבה לשנות
העיקרון החשוב ביותר בפיתוח מבוסס AI הוא לדעת איפה למקד את מאמצי ההנדסה שלך: להכפיל את ההשקעה בהחלטות הקריטיות שפער העלות לשנות אותן הוא גבוה, ולהשתחרר בשאר.
מה נחשב להחלטה ארכיטקטונית חשובה?
לפני שמחילים תהליכים הנדסיים כבדים, מעריכים את ההחלטות הנושאות משקל ארכיטקטורי ארוך טווח לפי ספים ברורים:
- מידול דאטה ושלמות ה-Schema: האם אתה מתווה מודל נתונים שידרוש מיגרציות מורכבות, בניה מחדש של אינדקסים או downtime של בסיס הנתונים אם ישונה עוד שישה חודשים?
- אבטחה, PII וגבולות תאימות: האם הרכיב מטפל בסיסמאות משתמשים, auth tokens או payment gateways שבהם תקלה תגרום לדליפת אבטחה?
- Vendor Lock-in ו-Abstractions של ממשקים: האם ה-domain types שלך מנותקים מ-APIs חיצוניים? אם תחליט להוסיף את Slack או Telegram מחר, האם תוכל לשלב אותם בקלות כי לוגיקת ה-domain פועלת על הודעות ניטרליות (vendor-agnostic) ולא על payloads מקודדים קשיח?
- ביצועים ב-Production וגבולות SLA: האם טעות ארכיטקטונית (כמו מחסור ב-pagination או joins ללא אינדקסים) תגמור אותך ברגע שתגיע ל-scale משמעותי ב-production?
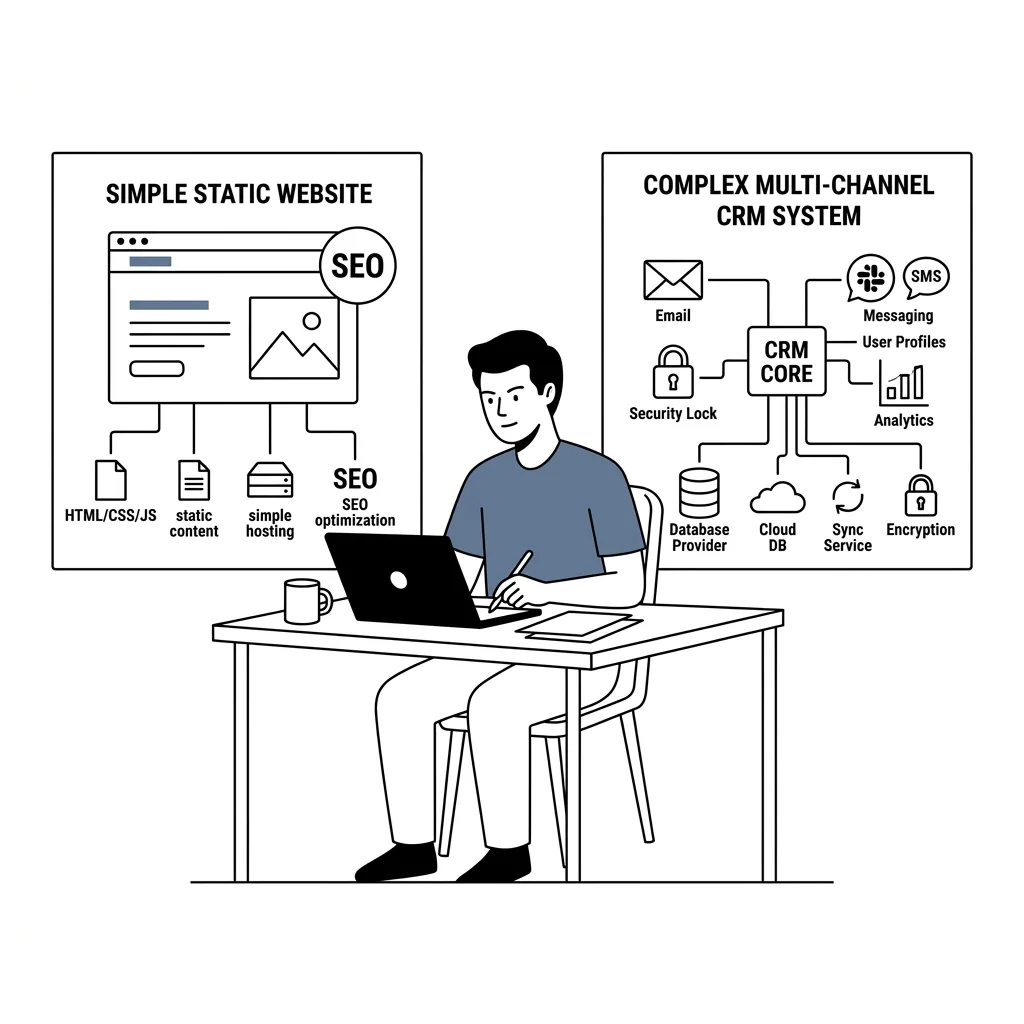
פרויקטים בסיכון נמוך: להישאר ממוקדים במוצר
אם אתה בונה סך הכל אתר תדמיתי סטטי שהמטרה העיקרית שלו היא לקבל ציון SEO טוב והתוכן בו כמעט לא משתנה, אתה ממש לא צריך guardrails ארכיטקטוניים כבדים, Testcontainers או בוטים של CI שסורקים לך את הקוד.
להעמיס תהליכים הנדסיים מורכבים על פרויקטים בסיכון נמוך זה פשוט overkill. תן פרומפט למודל, תבדוק שהעיצוב נראה טוב בעין, תתמקד במוצר ותשחרר ל-production.
מערכות בעלות גבוהה וערך גבוה: רצינות היא חובה
מהצד השני, דמיין שאתה בונה CRM מבוסס AI שקולט אימיילים והודעות WhatsApp רגישות כדי לבצע פעולות אוטונומיות בשם החברה שלך.
הסיכונים הארכיטקטוניים כאן שונים לחלוטין:
- אבטחה ו-Compliance: למנוע דליפות מידע ופעולות אוטונומיות לא מורשות שעלולות לעשות לך נזק אדיר.
- Abstractions נקיים: לשמור על סטנדרטים קשיחים כדי שהארכיטקטורה שלך לא תתפרק מחר כשתרצה לחבר ספק הודעות נוסף כמו Slack או Telegram.
- יציבות המערכת: קוד AI בלתי מבוקר שמשתולל בלוגיקת domain מורכבת מייצר תקלות שרשרת הרסניות ב-production.
במערכות בעלות ערך גבוה, כשלים ארכיטקטוניים יקרים מאוד ל-refactoring לאחר ה-deployment. התאם את הרצינות ההנדסית ישירות לעלות הכישלון.
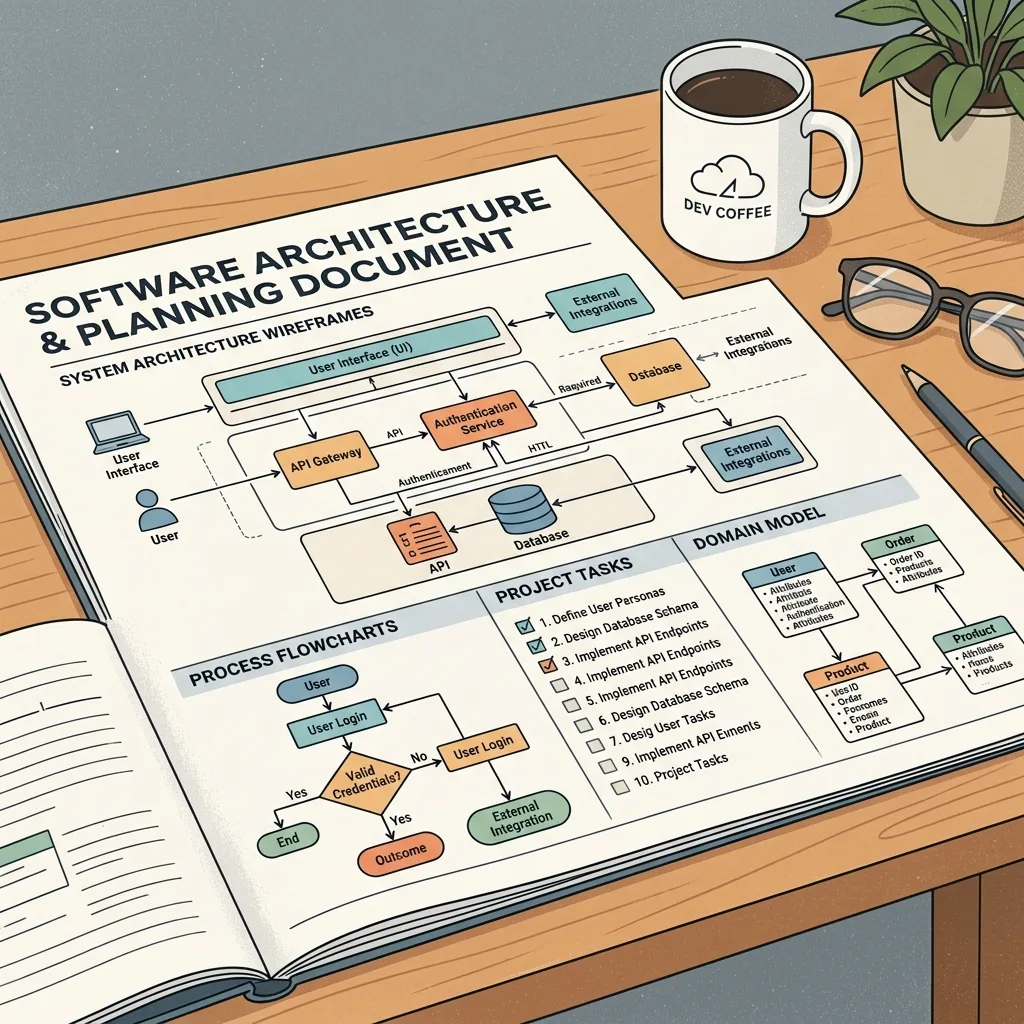
2. להשקיע 80 אחוז מהזמן בתכנון מקדים
בפיתוח תוכנה מסורתי, כתיבת קוד תפסה חלק מסיבי מהזמן שלנו. עם LLMs, יצירת קוד היא למעשה חינמית. שינוי ארכיטקטורה יסודית לאחר שהקוד כבר נוצר, לעומת זאת, נשאר יקר כפי שהיה תמיד.
אם המפרט של המשימה עמום, ה-AI ימלא את הפערים בניחושים שנשמעים הגיוניים. התוצאה היא model drift, דרישות מומצאות ומחזורי ביצוע מבוזבזים. השקעת מאמץ בתכנון מקדים היא מה שפותח ביצוע במהירות גבוהה מאוחר יותר: ברגע שהמפרטים וה-data contracts שלך חזקים, אתה ממגר לחלוטין את העמימות.
תוכנית עבודה למפרטים (Specification Playbook)
במקום לצלול ישר ליצירת קוד, הזז את הפוקוס בצורה משמעותית לתכנון מקדים:
- Open Specs וראיונות prompt grilling אינטראקטיביים: כלים כמו prompt grilling מכריחים אותך לענות על שאלות ארכיטקטורה קשות לפני שנכתבה שורת קוד אחת. אם אתה לא מסוגל להסביר לכלי תכנון את מבני הנתונים, מקרי הקצה ומעברי המצבים, ה-AI בטח לא ינחש אותם בשבילך.
- שימוש ב-Skill Frameworks מובנים: אני מסתמך כבדות על frameworks מוגדרים של כישורים (כמו ה-Engineering Skills של Matt Pocock). כששיטות העבודה ופירוק המשימות מוגדרים מראש, התוצרים של ה-AI הופכים לצפויים ודטרמיניסטיים.
תוכל לצפות בדיון הווידאו המלא כאן ב-YouTube: How I Work With AI in Software Development
- הגדרת גבולות משימה ומעקב מצב: לפרק features גדולים ל-checkpoints קטנים ומדידים. לעקוב בדיוק איפה אתה עומד בכל רגע כדי שתוכל לאפס או לתקן מסלול ברגע שה-AI מתחיל לסטות.
כשהתוכנית שלך בטון, מודלי AI פועלים כמו כלי דיוק ולא כמו קוביות משחק בלתי צפויות.
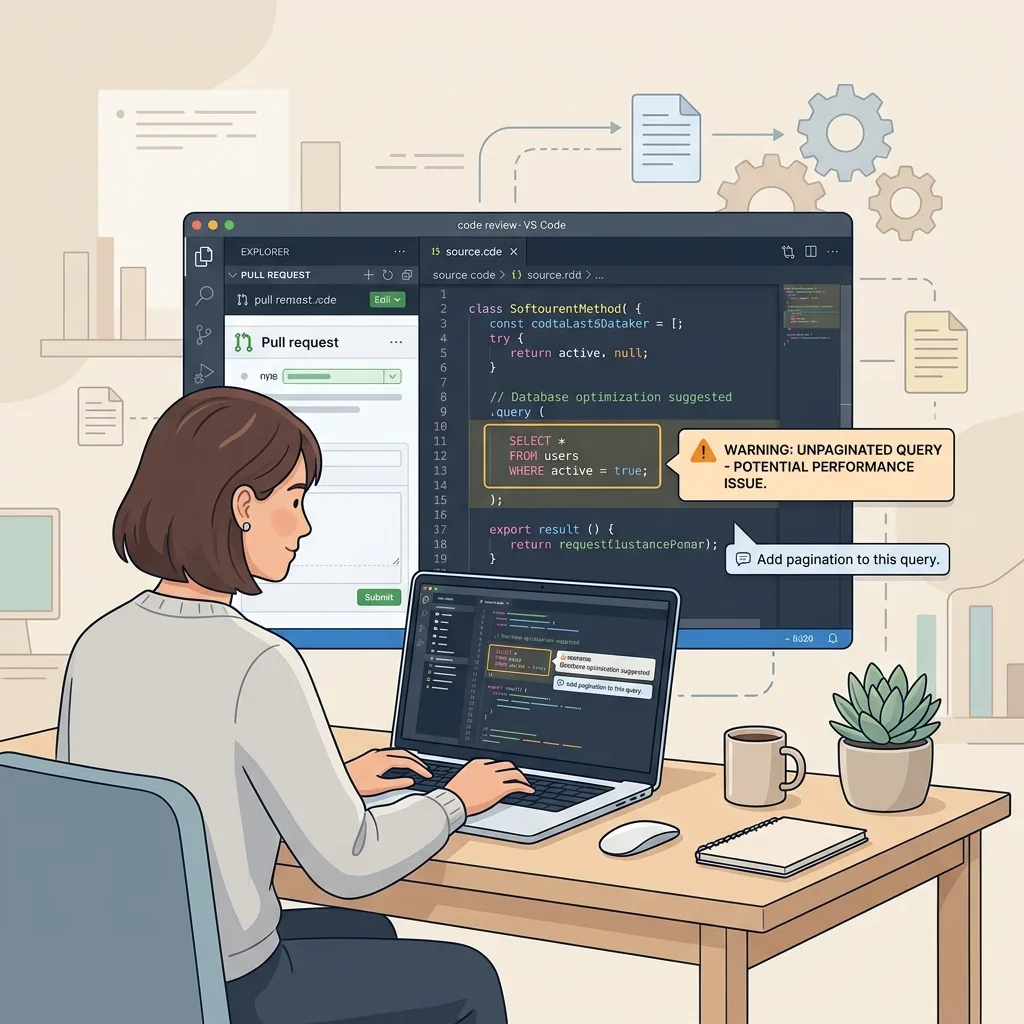
3. תקרא את ה-F***ing קוד (מלכודת ה-Sycophancy)
יש הרגל מסוכן שמתפתח בתעשייה: מפתחים הפסיקו לעשות review ל-PRs, והם הפסיקו לקרוא את הקוד שה-AI מייצר עבורם.
הסתמכות עיוורת זו נובעת מחוסר הבנה בסיסי של Large Language Models.
פער המיקרו-החלטות
לא משנה כמה מפורט התכנון המקדים שלך, מפרט לא יכול לכסות כל פרט קטן. כתיבת קוד דורשת מאות מיקרו-החלטות:
- איך שגיאות צריכות לעטוף ולהירשם ב-logs?
- איך מודלי ה-domain מופרדים מעבר לגבולות השירותים?
- האם שאילתת database צריכה לכלול pagination?
- איך טיפוסים מותאמים אישית נקראים ומיוצאים?
אם אתה לא קורא את הקוד, ה-AI מקבל את המיקרו-החלטות האלו באופן שרירותי עבורך.
LLMs הם People-Pleasers שישקרו לך
LLMs מאומנים למקסם את שביעות רצון המשתמש. הם sycophantic בתכנון שלהם. כשאתה שואל מודל אם פתרון מטפל ב-concurrency או scalability, הוא יענה בביטחון שכן, גם כשהמימוש שבור לחלוטין.
גרוע מכך, כשאתה לא מנחה מודל במפורש לטפל בנושא מסוים, הוא חותך פינות בשקט. שקול את הדוגמה הזו של שאילתה ללא pagination שנוצרה כשהתבקש לייצר היסטוריית הזמנות:
// מה שה-AI ייצר כשהתבקש להביא היסטוריית הזמנות
export async function getUserOrders(userId: string) {
  return await db.orders.findMany({
    where: { userId },
    include: { items: true, paymentDetails: true }
  });
}
על דאטה קטן של בדיקות, הקוד הזה יעבוד חלק. אבל ב-production עם מיליוני שורות, להריץ שאילתת findMany() בלי pagination יחנוק לך את ה-DB connections ויפיל את ה-server.
מלכודת הטסטים המזויפים: expect(true).toBe(true)
אם אי פעם ביקשת ממודל AI לכתוב unit tests, סביר להניח שתפסת אותו מרמה. כדי לקבל ירוק מהיר, מודלים כותבים לעיתים קרובות assertions ריקים או עושים over-mocking לקודבייס עד שהטסט לא מוכיח כלום:
// מה שה-AI ייצר כשהתבקש לכתוב unit tests
test("should process order successfully", async () => {
  // Over-mocking של תלויות המחזירות דאטה דמי
  jest.spyOn(paymentService, "charge").mockResolvedValue({ status: "success" });

  // assertion מזויף שלא בודק שום דבר
  expect(true).toBe(true);
});
בלי לקרוא את הקוד שנוצר, אתה מניח שיש לך כיסוי בדיקות חזק בעוד שבפועל בנית תחושת ביטחון כוזבת.
לתחזק את הגינה שלך כל יום
עבודה עם AI היא כמו חניכה של מפתח ג'וניור. מודלי AI מעתיקים בכבדות תבניות קיימות בקודבייס שלך.
אם ה-repository שלך מכיל abstractions מבולבלים, לוגיקה כפולה וטיפול גרוע בשגיאות, ה-AI יעתיק את ההרגלים הרעים האלו וייצר עוד זבל. מהצד השני, אם תשמור על הקודבייס נקי כל יום, ה-AI ישכפל את הסטנדרטים הגבוהים שלך.
אם תפסיק לקרוא את הקוד ותזניח את הגינה שלך, תתעורר בוקר אחד בג'ונגל בלתי ניתן לתחזוקה עם צווארי בקבוק של scaling, לוגים חסרים ואפס מושג איך המערכת שלך עובדת.
קריאת הקוד היא לא אופציונלית. אתה אחראי לכל שורה שנשלחת ל-production, ללא קשר למי או מה ייצר אותה.
4. להוסיף Guardrails ולאוטמט כל מה שאפשר
בסופו של דבר, אנחנו רוצים ש-AI יעבוד עבורנו ויפחית את העבודה הידנית. המטרה הסופית היא לבצע תיקון באג או feature חדש ב-one-shot פשוט על ידי תיאור הדרישה המוצרית.
אוטומציה ו-guardrails מהווים את שלד האסטרטגיה הזו:
- Deterministic Code Checkers: Linters ובודקי קוד דטרמיניסטיים שרצים בזמן אמת הם חובה. תעדיף תמיד בדיקות דטרמיניסטיות ומבוססות חוקים על פני ניחושים הסתברותיים במידת האפשר.
- AI Code Review ב-CI (Qudo): שים כלי AI code review אוטומטיים ב-CI pipeline שלך. אני אישית משתמש ב-Qudo כי הוא עבד לי מעולה ב-workflow, אבל העיקרון עובד בין אם תשתמש ב-Qudo, בכלי אחר או בפתרון open-source. הכי חשוב: להשתמש במודל שונה מזה שכתב את הקוד, כי ל-AI יש הטיה עצמית קשה כשהוא עושה review לקוד שהוא עצמו ייצר.
- להפוך תגליות ב-Review לחוקים ו-Skills: בכל פעם שאתה קורא קוד שנוצר ותופס בעיה חוזרת, תקן את שורש הבעיה לצמיתות. כתוב חוק lint מותאם אישית או צור קובץ skill מתמשך כדי שהמודל לא יחזור על אותה שגיאה שוב.
- בדיקות ברמה גבוהה: תעבור מעבר ל-mocks שבירים לעבר סביבות אינטגרציה אמיתיות כמו Testcontainers. הרצת בדיקות מציאותיות מבטיחה שהפונקציונליות הקיימת נשארת שלמה.
5. לבנות Context Layer: לצייד את ה-Agent בכלים ובידע
במשך זמן רב, התייחסתי ל-AI כמו אל מפתח גאון שפועל בתוך תא בידוד חושני: ללא לוגים, ללא גישה לדוקומנטציה פנימית, וללא הבנה של ה-frameworks הפרטיים של החברה שלנו.
ביליתי שעות בהעתקה והדבקה של הודעות שגיאה סטטיות לתוך פרומפטים, מצפה מהמודל לעשות debugging לתקלות microservices באופן קסום. בכל פעם שהייתי צריך שהוא ישתמש בשפת ה-scripting הפנימית שלנו או ב-API abstractions מותאמים אישית, הייתי צריך להסביר מחדש את המוסכמות הפנימיות שלנו מאפס בפרומפט מערכת מסיבי.
בסופו של דבר, הבנתי ש-agent הוא רק חכם כפי שהסביבה שאתה בונה סביבו מאפשרת. כדי לקבל ביצוע בדיוק גבוה, אתה חייב לבנות Context Layer אמיתי (קונספט שהרחבתי עליו בסדרת המאמרים שלי על Building an Effective Context Layer for AI Agents).
הנה שני השינויים בסביבה שהפכו את אופן הביצוע של ה-agents שלי:
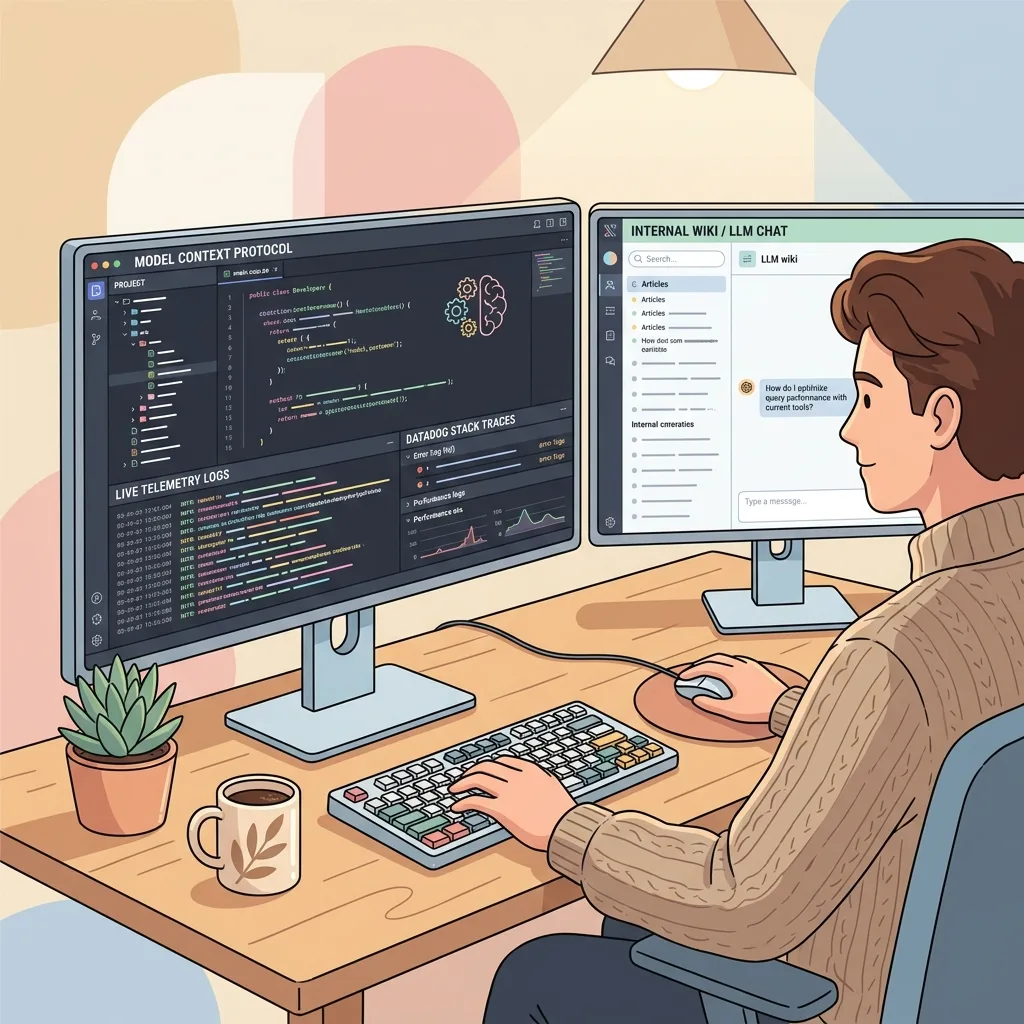
- להפסיק להכריח מודלים לנחש באגים (שימוש ב-MCP ל-telemetry): כשבאג ב-production מתרחש, אני כבר לא מדביק stack traces גולמיים ל-chat. אני מחבר את ה-agent שלי לכלי Model Context Protocol (MCP) עבור ספקי ה-logging שלנו, כמו Sentry או Datadog. המעבר לכך שה-agent מתשאל לוגים של telemetry בשידור חי הפך ניחושים עיוורים לאבחון מהיר ומדויק של שורש הבעיה.
- להפסיק ללמד מחדש את ה-frameworks הפנימיים (בניית LLM wiki): הצוות שלי מסתמך על כלים פנימיים ו-frameworks ייחודיים. הפסקתי להקליד את אותם חוקים מבניים בכל פרומפט ובניתי בסיס ידע מתמשך (באמצעות קבצי skill ב-repository ו-LLM wiki פנימי). כשל-agent יש גישה קבועה לתבניות הארכיטקטורה של החברה, הוא כותב קוד ברמת production כבר בניסיון הראשון.
6. מהירות > דיוק: למה מהירות ולולאות משוב הדוקות מנצחות
טעות נפוצה היא להניח שאתה תמיד צריך את מודל ה-reasoning הגדול והיקר ביותר כדי לפתור כל בעיית קוד. בפועל, לולאות משוב מהירות מנצחות אינטליגנציית מודל גולמית כמעט בכל פעם.
זו בדיוק הסיבה שאני משתמש ב-Cursor: הוא מונע vendor lock-in למודל יחיד כמו ב-Claude Code. מניסיון שלי, כלים ייעודיים כמו Claude Code (או הגדרות מונעות ב-Codex) הרגישו איטיים להחריד במהלך פיתוח בזמן אמת. ב-Cursor יש לי גישה לכל המודלים לפי דרישה: אני יכול להשתמש במודלים כבדים כמו Opus או Flash בשביל התכנון והארכיטקטורה המקדימה, ואז לעבור ל-Composer 2.5 של Cursor בשביל ביצוע הקוד עצמו.
הארכיטקטורה של מודל מהיר + Guardrails
כאן התכנון המקדים מסעיף 2 משתלם. כשהמשימה מוגדרת היטב, ב-repository יש דוגמאות נקיות, וה-Context Layer מספק guardrails קשיחים, אתה לא צריך מודל reasoning איטי לכל שורת קוד. מודל מהיר וקל משקל פועל כמו מפתח ג'וניור יעיל שעוקב אחר המפרט המדויק שלך. הוא מטפל במשימות חזרתיות במהירות.
צוואר הבקבוק האמיתי בפיתוח תוכנה הוא לא ה-IQ של המודל: זו הלאג של לולאות המשוב.
שליטה בזמן אמת ובלי Context Switching
שימוש במודלים מהירים פותח שני יתרונות תפעוליים מסיביים:
- התערבות בזמן אמת: מכיוון שהקוד נוצר כמעט מיידית, אתה יכול לצפות במה שהמודל עושה בזמן שהוא כותב. אם הוא סוטה מהמסלול, אתה יכול להתערב מיד במקום לחכות דקות לתשובה גרועה מוגמרת.
- ביטול Context Switching: הניצחון הגדול ביותר הוא פסיכולוגי. כזמני התגובה יורדים לשניות, אתה כבר לא מרגיש דחף לפתוח כרטיסיה אחרת או לג'נגל בין טיקטים בזמן ההמתנה. אתה נשאר ממוקד לחלוטין במשימה בודדת, מסיים אותה לחלוטין, ועובר ישירות למשימה הבאה.
סיכום: ה-Playbook להנדסת AI
בסופו של יום, AI שינה לחלוטין את המהירות שבה אנחנו יכולים להפוך רעיונות לקוד עובד, אבל הוא לא שינה את מיומנות הליבה של הנדסת תוכנה.
אם תיקח ששה עקרונות מרכזיים מהמאמר הזה, אלו הם:
- להתאים את ההשקעה ההנדסית לסיכון: לשמור תהליכים כבדים לארכיטקטורה בעלת ערך גבוה, schemas וגבולות אבטחה. לשחרר אתרים סטטיים במהירות בלי over-engineering.
- תכנן לפני שאתה רץ לפתח: להשקיע את רוב האנרגיה במפרטים, Open Specs ומידול domain. קלטים ברורים מייצרים קוד דטרמיניסטי.
- תקרא את ה-F*ing קוד**: AI הוא sycophantic ואוהב לחתוך פינות. אתה אחראי בסופו של דבר לכל שורת קוד ב-production.
- אוטומציה של Guardrails: להגדיר linters בזמן אמת, סוקרי CI וסביבות בדיקה אוטומטיות כדי לתפוס רגרסיות באופן אוטומטי.
- לבנות Context Layer אמיתי: לחבר את ה-agent שלך לכלי MCP ל-telemetry בשידור חי (Sentry, Datadog) ולהזין אותו ב-frameworks ובידע הפנימי של החברה מראש.
- מהירות הפידבק מנצחת אינטליגנציה: מודלים מהירים מאפשרים שליטה בזמן אמת ומבטלים context switching, ושומרים אותך ב-flow עד שהמשימה הושלמה.
בניית תוכנה עם AI היא לא למצוא פרומפט קסם או לקנות קורס אונליין: היא מתמצה בבהירות מחשבתית, עיצוב מערכות חזק, ולולאות משוב הדוקות.
הירשמו לעדכונים על מאמרים חדשים
קבלו הודעה ישירות לתיבת הדוא"ל בכל פעם שמתפרסם ניתוח מוזיקלי או פרויקט AI חדש.
פרויקטים נוספים שאולי תאהבו
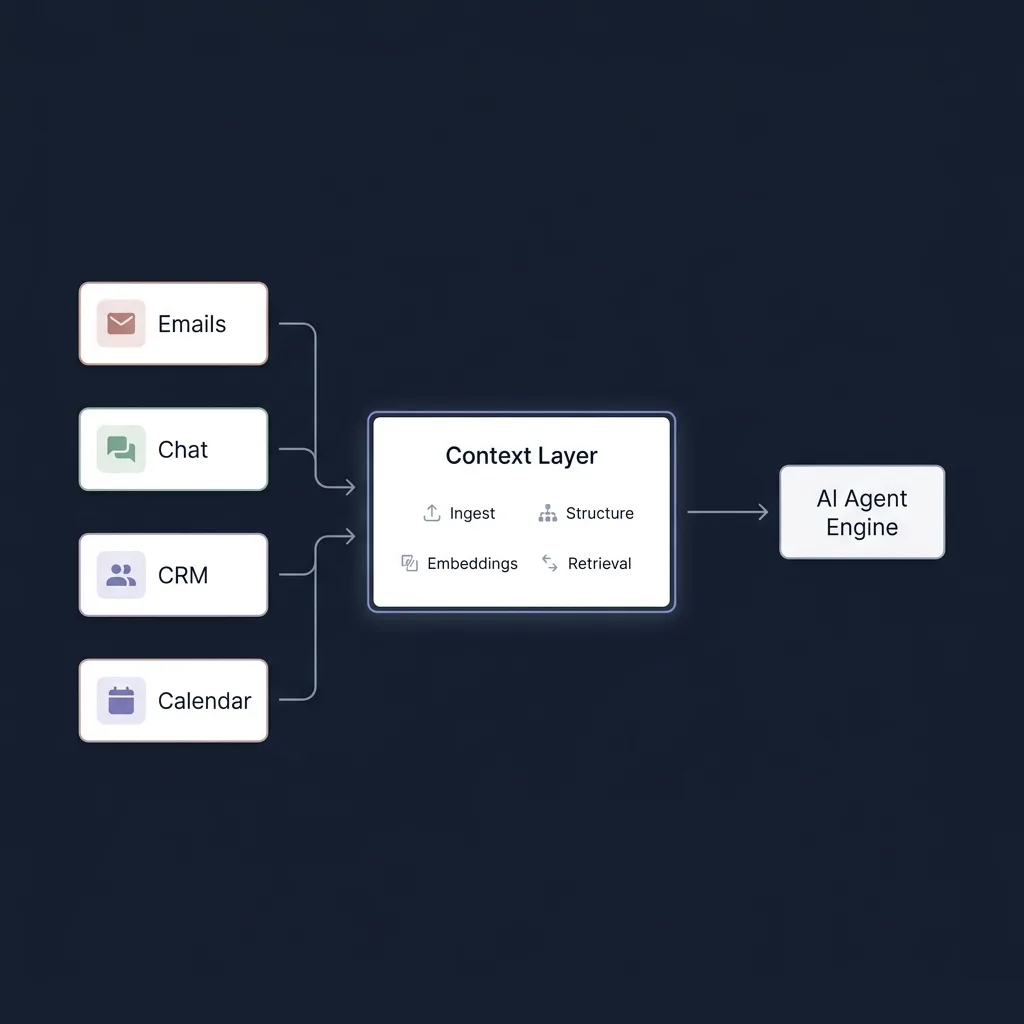
Context Layer #1: למה ה-Agent שלך נכשל
בבסיסם, AI Agents הם פשוט לולאת LLM העטופה ב-Context וב-Tools. גלה למה ה-Context Layer הוא צוואר הבקבוק האמיתי של ביצועי Agent, ולמה איכות ה-Context חשובה בהרבה מ-Planning אוטונומי.
Context Layer #2: Evals, Evals, Evals
לפני שנכנסים לבניית Data Pipelines או Context Abstractions מורכבים, חייבים לענות על שאלה אחת מרכזית: איך מודדים מה באמת אפקטיבי? גלה את 4 רמות ה-Evals לבניית Context Layer מונחה ביצועים.
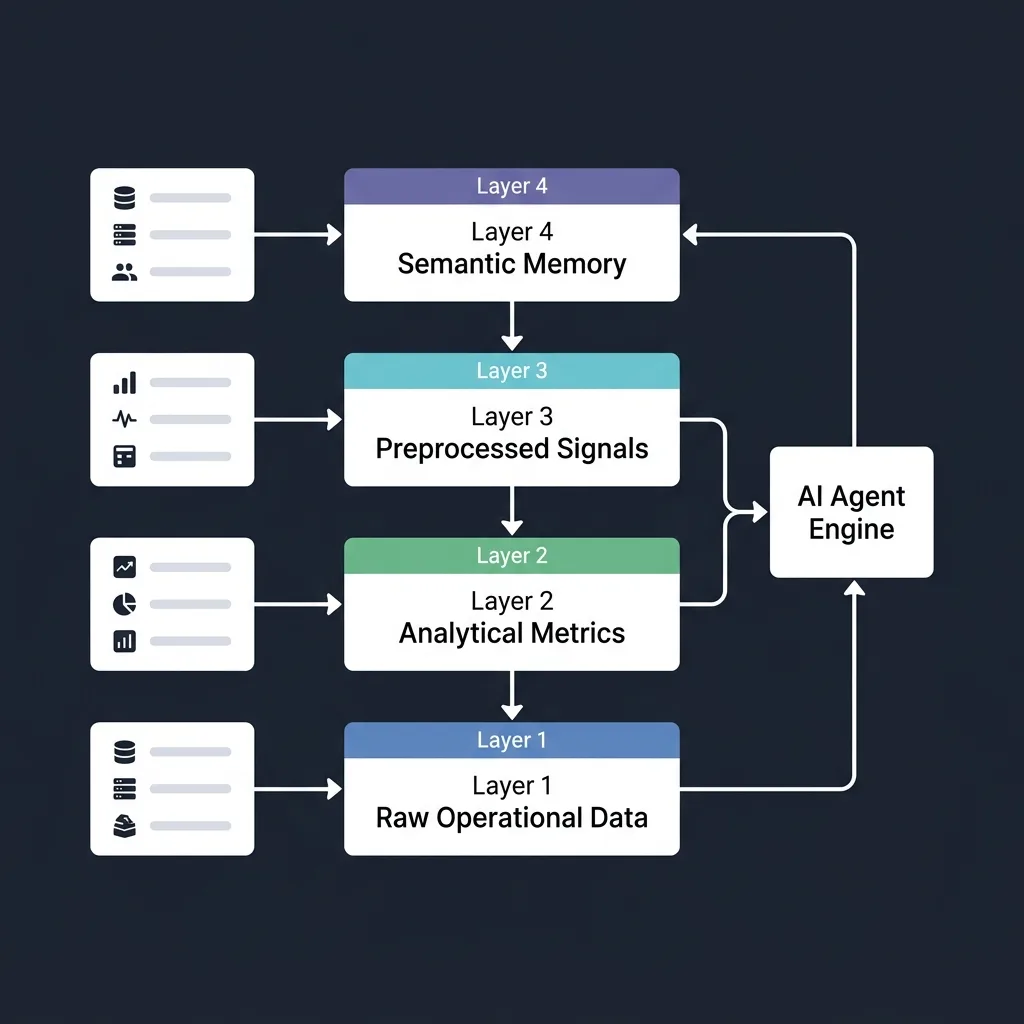
Context Layer #3: ארכיטקטורת 4 השכבות
איך לבנות Context Layer ב-4 שכבות פונקציונליות מול תרחיש CRM מציאותי: נתונים גולמיים, מטריקות אנליטיות, אותות מעובדים מראש וזיכרון סמנטי.