
Context Layer #4: קליטת דאטה תפעולי
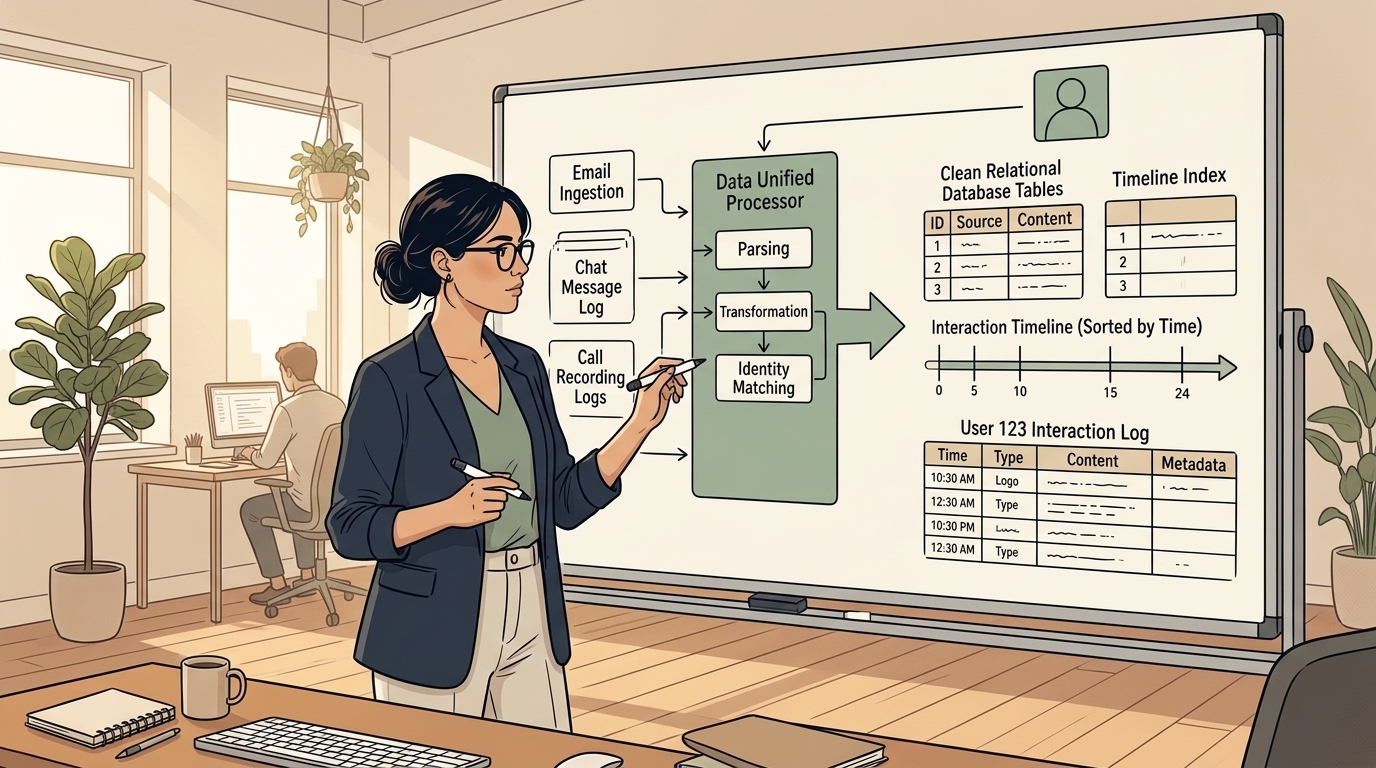
זהו חלק 4 בסדרה בת 7 חלקים על Context Layers עבור AI Agents. אם עדיין לא קראתם את החלקים הקודמים, התחילו עם חלק 1: מהו Context Layer, חלק 2: איך מגדירים ומודדים Context Layer אפקטיבי, ועם חלק 3: ארכיטקטורת Context בארבע שכבות.
TL;DR: שכבה 1 מעתיקה דאטה תפעולי מספקים חיצוניים למאגר שבשליטתכם. היא מנרמלת את הדאטה לישויות של המוצר, כמו אנשי קשר, הודעות ושרשורים. קודם שומרים את האירוע הגולמי, אחר כך פותרים זהויות דרך Projection משותף, ולבסוף בונים אינדקס לכל שאלה שה-Agent צריך לענות עליה.
למה שכבה 1 קיימת
לחבר כלי Agent ישירות ל-APIs של ספקים חיצוניים נראה פתרון פשוט בהתחלה, אבל הוא קורס ברגע שמגיעים למשתמשים אמיתיים.
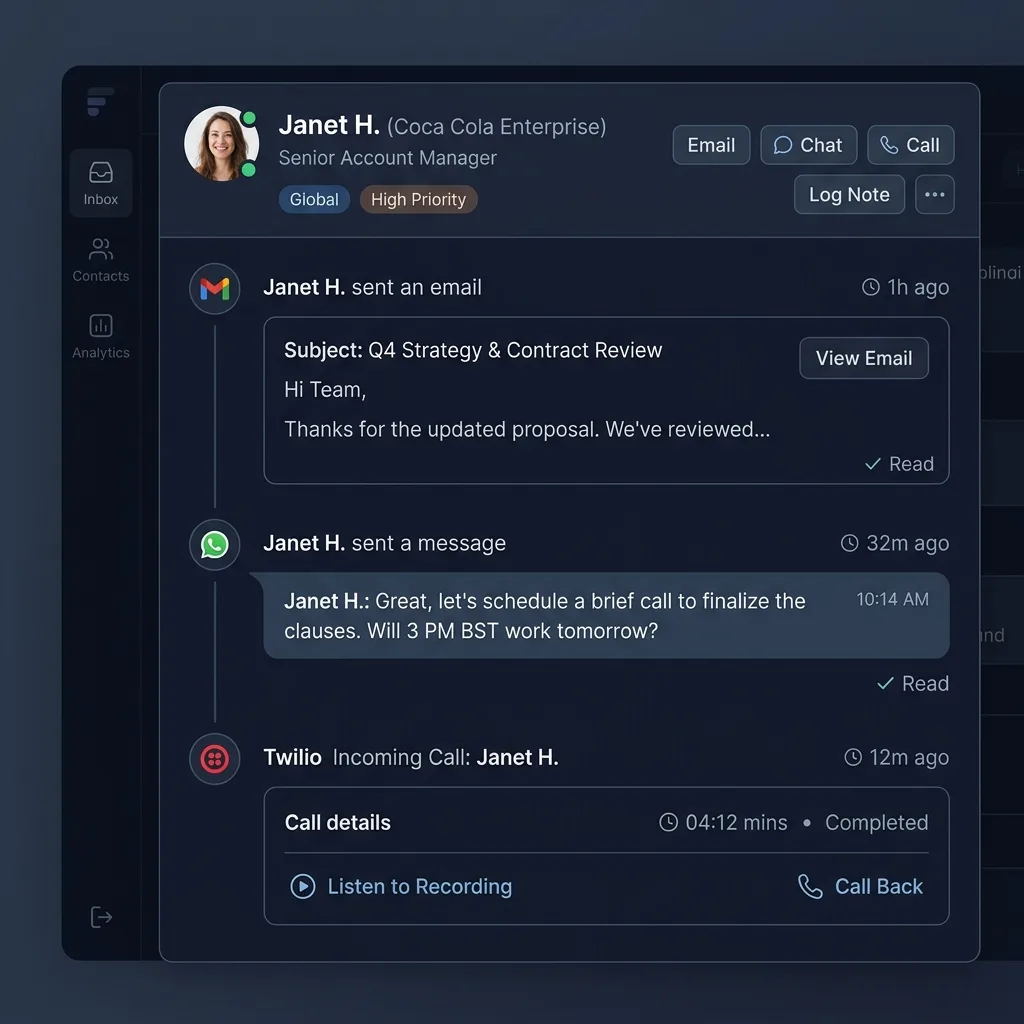
נניח שה-Agent צריך לענות על השאלה: "האם ג׳אנט ענתה להצעת החידוש שלנו, ומה סיכמנו איתה?"
אם ה-Agent פונה ל-APIs חיצוניים בזמן אמת, הוא נאלץ לתשאל את Gmail, את WhatsApp ואת יומני השיחות בזמן שהמשתמש ממתין לתשובה. החיבור הזה יוצר ארבעה כשלים הנדסיים מיידיים:
- זה איטי ונשבר בקלות: פנייה לשלושה ספקים לוקחת עשר שניות, ואם ספק אחד נתקע או מפעיל Rate Limit, כל התשובה נכשלת.
- הספקים לא מדברים זה עם זה: ל-Gmail אין מושג מה הטלפון של ג׳אנט ב-WhatsApp. בלי מסד נתונים, ה-Agent צריך לנחש ולחבר את הרשומות בתוך הפרומפט.
- דאטה מבולגן שורף Tokens: התשובות מה-APIs מלאות במידע טכני מיותר שמנפח את הפרומפט ועולה כסף.
- תכנון שגוי: אף אתר לא טוען עמוד על ידי קריאה לשלושה ספקים בזמן אמת, ואין סיבה לתת ל-Agent לעשות את זה.
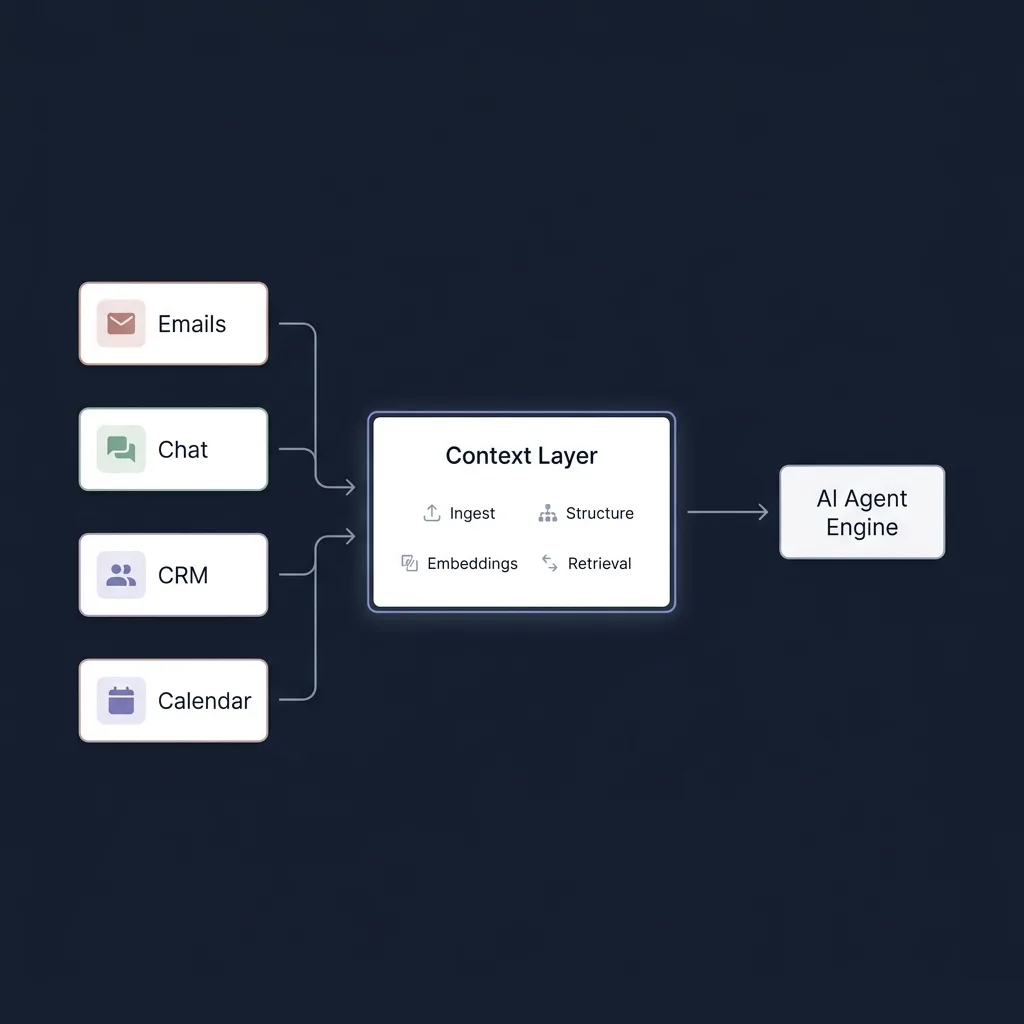
שכבה 1 פותרת את הבעיה הזו על ידי הוצאת עבודת החיבור מסבב השיחה. היא קולטת אירועים ברקע באופן רציף, מנרמלת אותם למודל ה-Domain של המערכת, ושומרת אותם ב-Relational Database עם אינדקסים מדויקים לשאלות שהמוצר נדרש לפתור.
בזמן הריצה, ה-Agent מתשאל את מסד הנתונים הפנימי במילישניות ובאמצעות Contract אחיד ונקי. ה-Agent פועל כפי שצריך: הוא לקוח נוסף של מודל הדאטה המרכזי, שרואה בדיוק את אותה תמונת מצב שמציג ממשק המוצר.
ה-Agent הוא לקוח, לא צינור נתונים: לעולם אל תאלצו את מודל ה-AI לשמש כמנוע אינטגרציה במהלך שיחה. קלטו את המידע מראש, נרמלו אותו פנימית, ותנו ל-Agent לתשאל מסד נתונים מסודר.
מתחילים מהשאלות
אל תתחילו מבחירה בין PostgreSQL, Kafka ו-Elasticsearch. התחילו מהשאלות שהמוצר צריך לענות עליהן:
- חיפוש איש קשר: מי זאת
janet@example.com, ולאיזה Account היא שייכת? - חיפוש בציר הזמן: אילו הודעות, שיחות ופגישות שייכות לג׳אנט?
- חיפוש טקסט: אילו שיחות מזכירות את הצעת החידוש?
- Identity Resolution: האם השולחת מ-Gmail והמשתתפת ב-WhatsApp הן אותה אישה?
מתחילים מ-Access Patterns: השאלות מגדירות את מודל הדאטה, האינדקסים וכלי ה-Agent. אם אי אפשר לענות דרך שאילתה מוגבלת ומאונדקסת, התכנון עדיין לא שלם.
שמירת הדאטה לפני שה-Agent מבקש אותו
כדי שה-Agent יענה במילישניות, הוא לא יכול לחפש מידע בזמן אמת. הדאטה חייב לחכות לו במסד הנתונים עוד לפני שהשיחה מתחילה.
לשם כך צריך צינור Ingestion פשוט ברקע עם שלוש משימות מרכזיות:
- לתפוס ולשמור את האירוע הגולמי: ברגע שאימייל או הודעת WhatsApp מגיעים, מקבלים את ה-Webhook ושומרים את ה-Payload הגולמי מיד בתור או במאגר אירועים. לא מעבדים אותו עדיין, אלא רק מוודאים שהוא שמור כדי שאפשר יהיה להריץ אותו שוב במקרה של תקלה.
- לנקות ולנרמל ברקע: Worker מושך את האירוע מהתור, מסיר מידע מיותר של הספק, וממפה את הדאטה לישויות הפנימיות שלכם (כמו
Contact,Messageו-Thread). - להתמודד עם תקלות של ספקים: ספקים חיצוניים שולחים לפעמים את אותו אירוע פעמיים, שולחים הודעות בסדר לא נכון, או חווים ניתוקים. מתמודדים עם זה בעזרת מפתחות מניעת כפילויות (Deduplication) ומנגנוני Retry אוטומטיים.
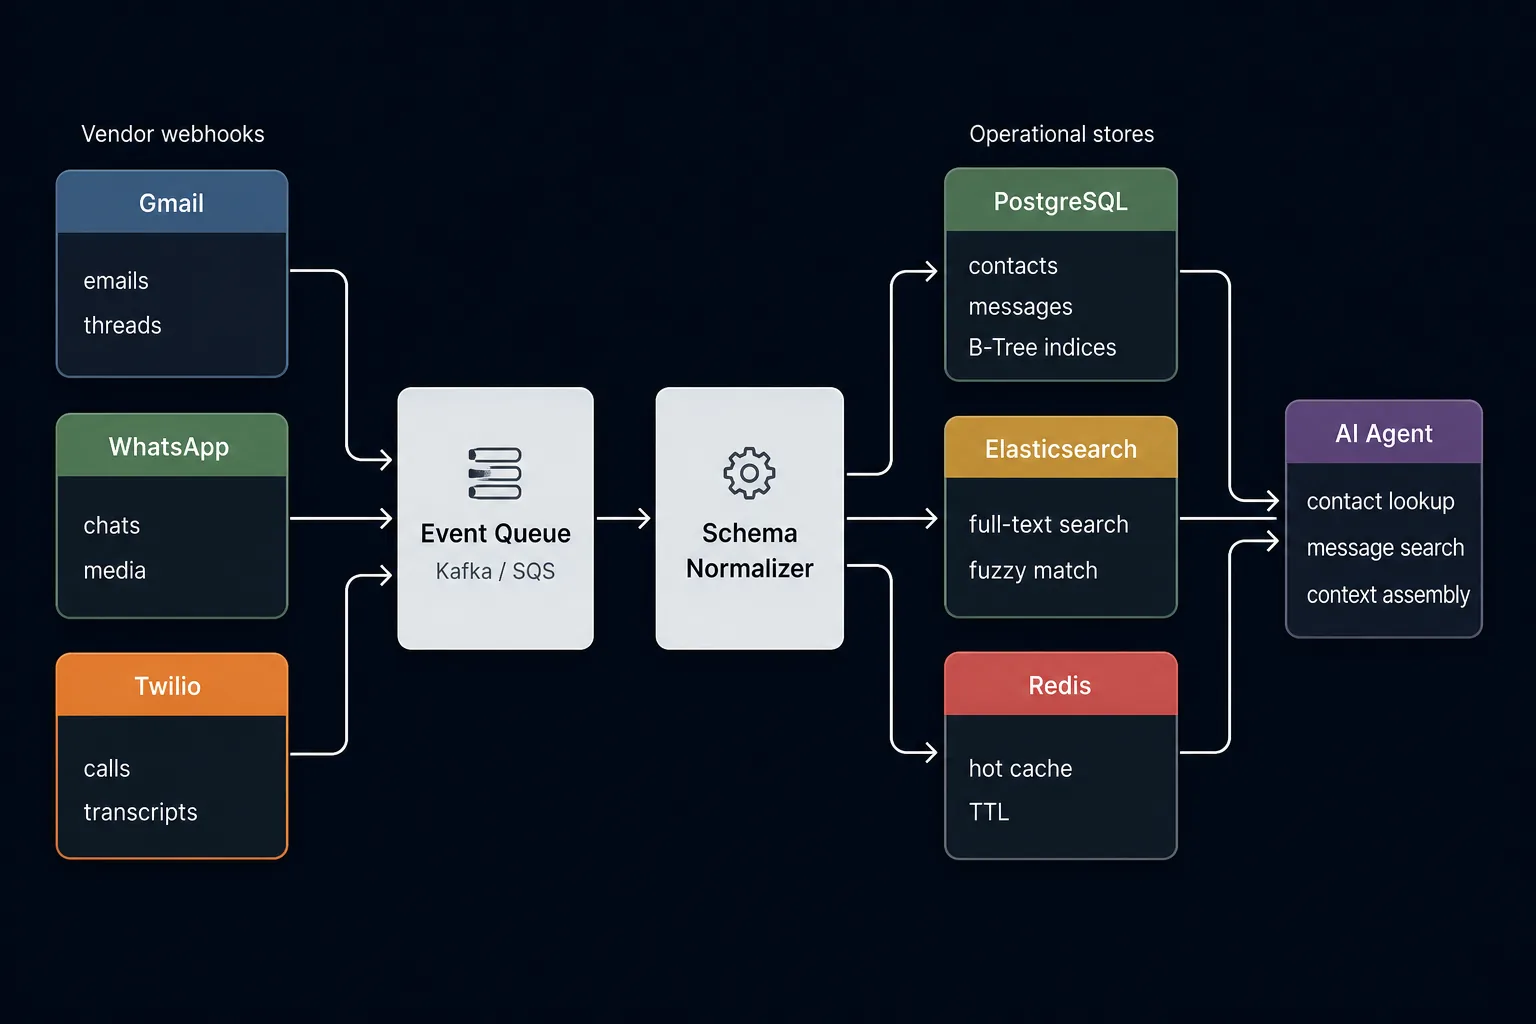
קודם שומרים, אחר כך מעבדים: תמיד שמרו את ה-Payload הגולמי של הספק לפני העיבוד. אם לוגיקת הנירמול תשתנה או תכיל באג, תוכלו להריץ את התור מחדש מבלי לאבד מידע של לקוחות.
מנרמלים ספקים למודל Domain אחד
הכנסת אירועים לתור היא רק חצי מהעבודה. ההחלטה הארכיטקטונית החשובה ביותר בשכבה 1 היא לשמור את הדאטה בשפה של ה-Domain שלכם, ולא במבנה הגולמי של Gmail, WhatsApp או Slack.
כל ספק מגדיר מושגים דומים במבני JSON שונים לחלוטין. מסד הנתונים שלכם צריך לנרמל אותם לישויות אחידות של המוצר: Contact, Message ו-Thread.
type SourceIdentity = {
  provider: string;
  sourceAccountId: string;
  externalId: string;
};

interface Contact {
  id: string;
  tenantId: string;
  displayName: string;
  identities: SourceIdentity[];
}

interface Message {
  id: string;
  tenantId: string;
  threadId: string;
  senderContactId: string;
  source: SourceIdentity;
  body: string;
  occurredAt: string;
  ingestedAt: string;
}
ה-IDs של Contact ושל Message הם פנימיים. SourceIdentity שומר את חשבון המקור ואת ה-ID החיצוני לצורך Deduplication ו-Lineage. ספק חדש דורש Adapter חדש, אבל לא משנה את כלי אנשי הקשר וההודעות של ה-Agent.
לא חושפים סכמות של ספקים ל-Agent: כלי ה-Agent צריכים לחשוף ישויות Domain פנימיות כמו אנשי קשר והודעות, ולא מבני נתונים ספציפיים של Gmail או WhatsApp.
פותרים זהות דרך צינור ה-Ingestion
אחרי שהאירוע הגולמי נשמר, הצינור יכול לבדוק אם ג׳אנט מ-Gmail וג׳אנט מ-WhatsApp הן אותה אישה. התהליך יכול להיות אסינכרוני כדי שמקרה לא ודאי לא יחסום Ingestion.
התחילו מאימיילים מאומתים, מזהי מקור, מספרי טלפון והקשר של Account. שמרו את הראיות, שיטת ההתאמה וה-Confidence של כל קישור. כאשר הראיות חלשות, השאירו אנשי קשר נפרדים והעבירו את ההצעה ל-Review.
פותרים זהות פעם אחת: כל הצרכנים צריכים להשתמש באותו Canonical Projection במקום להחליט על זהות בעצמם.
מודל מחזור החיים של הישויות
לא כל סוגי הדאטה מתנהגים באותו אופן. אימיילים הם אירועים קבועים, בעוד שאנשי קשר ושלבי עסקאות משתנים כל הזמן:
| סוג דאטה | התנהגות | אסטרטגיית שמירה |
|---|---|---|
| אימייל או יומן שיחה | Append only | שומרים פעם אחת ולא דורסים רשומות |
| הערה או איש קשר | Mutable | שומרים גרסה עדכנית לצד היסטוריית שינויים |
| שלב בעסקה | State machine | מתעדים כל שינוי סטטוס ומציגים את השלב הנוכחי |
אם ספק מוחק אימייל, מסמנים אותו במחיקה רכה (Tombstone) במקום למחוק את ההיסטוריה בשקט. אם איש קשר מתעדכן, דוחים עדכונים ישנים לפי Timestamp. כך ה-Agent יודע גם מה המצב הנוכחי וגם מה בדיוק קרה בעבר.
שומרים את המצב ואת ההיסטוריה שלו: כל תוצאה צריכה לכלול מקור וזמן עדכון, כדי שה-Agent יוכל להבדיל בין עובדה נוכחית לבין אירוע היסטורי.
הרשאות ו-Retention הם חלק מה-Contract
העתקת דאטה מספק חיצוני מעתיקה גם את חובות האבטחה והפרטיות שלו. כל שורת נתונים, מסמך חיפוש וערך ב-Cache חייבים להגדיר גבול Tenant מובהק.
שני כללים שומרים על אבטחת המידע של ה-Agent:
- הרשאה לפני שליפה: סננו דאטה ברמת שאילתת מסד הנתונים לפי Tenant והרשאות משתמש. לעולם אל תטענו מידע רגיש לפרומפט בתקווה שמודל ה-AI יסנן אותו בעצמו.
- מחיקות מתפשטות לכל המערכת: כשמשתמש מוחק אימייל או מבקש הסרת מידע, מחקו את התוכן מכל מסדי הנתונים, אינדקסי החיפוש וה-Cache. השאירו סימון Tombstone כדי לדעת שהרשומה נמחקה מבלי להחזיק מידע רגיש.
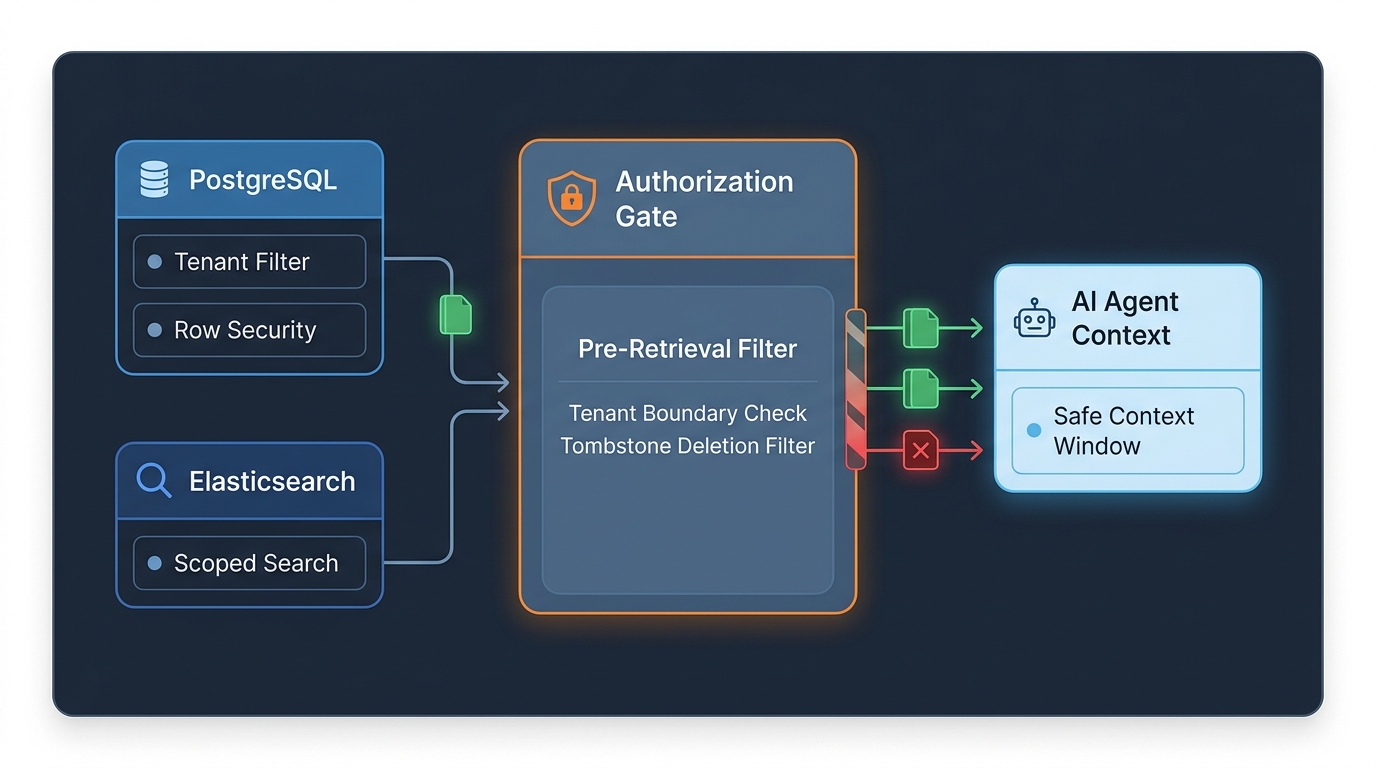
ההרשאה נעה עם הדאטה: כל שאילתה ו-Projection חייבים לשמור על Tenant Scope, הרשאות מקור ומצב מחיקה.
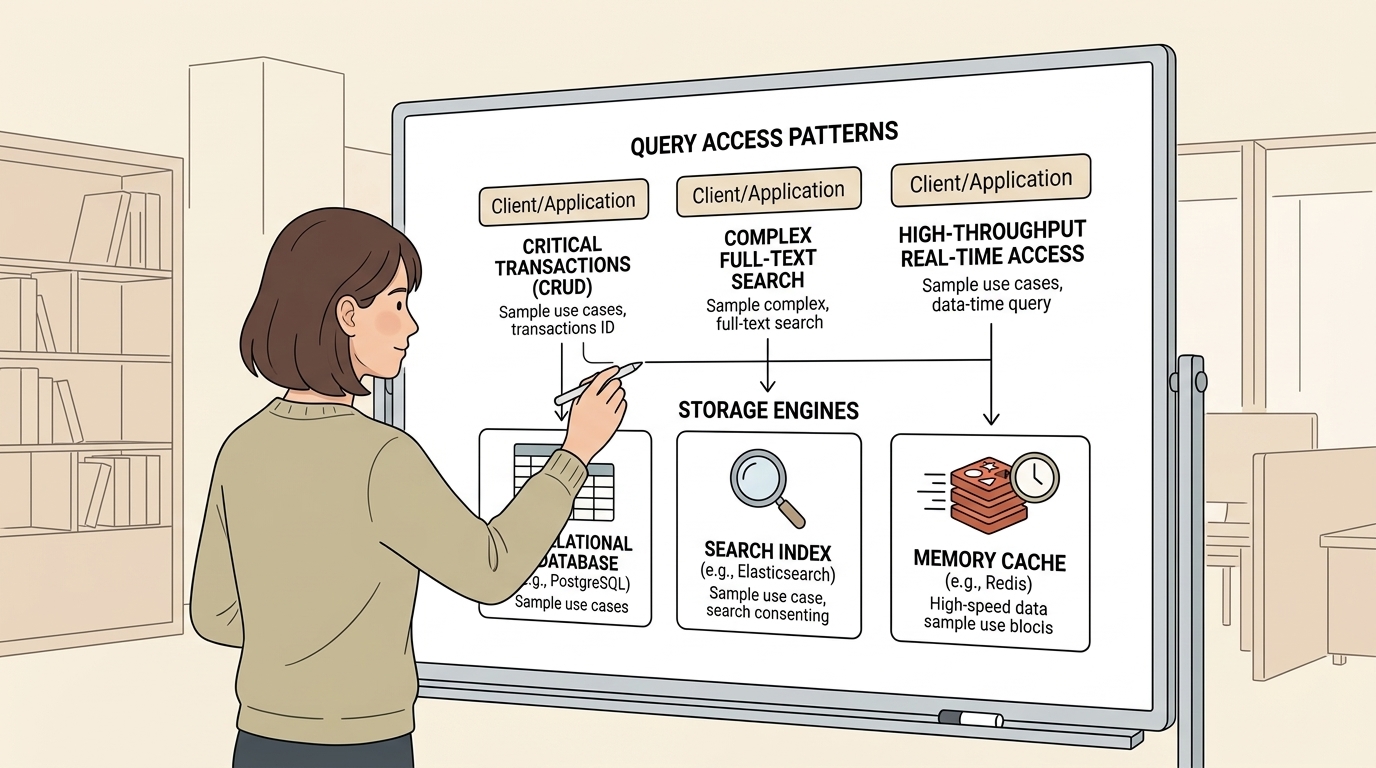
דפוסי הגישה מגדירים את הכלים
דפוסי הגישה שלכם הם אלה שמכתיבים את כלי האחסון, ואף פעם לא להפך.
נכתבו ספרים שלמים על בחירת מסדי נתונים, אבל הנה המתכון המעשי שפותר 95 אחוז מהצרכים של AI Agents:
- PostgreSQL עבור ישויות וצירי זמן: שליפות מדויקות של אנשי קשר, קשרים בין טבלאות ומיון כרונולוגי של הודעות.
- Elasticsearch עבור חיפוש טקסט: שגיאות כתיב, חיפוש מילים גמיש ודירוג תוצאות על פני מיליוני שיחות.
- Redis עבור זיכרון מטמון: שמירת פרופילים שנקראים שוב ושוב במהלך שיחה כדי לחסוך זמן תגובה.
כלל דפוסי הגישה: לעולם אל תבחרו כלי אחסון כי הוא פופולרי. הגדירו קודם כל את דפוסי הגישה, ותנו לשאלות המוצר לבחור את הכלי המתאים.
מתחילים קטן בלי לסגור אפשרויות
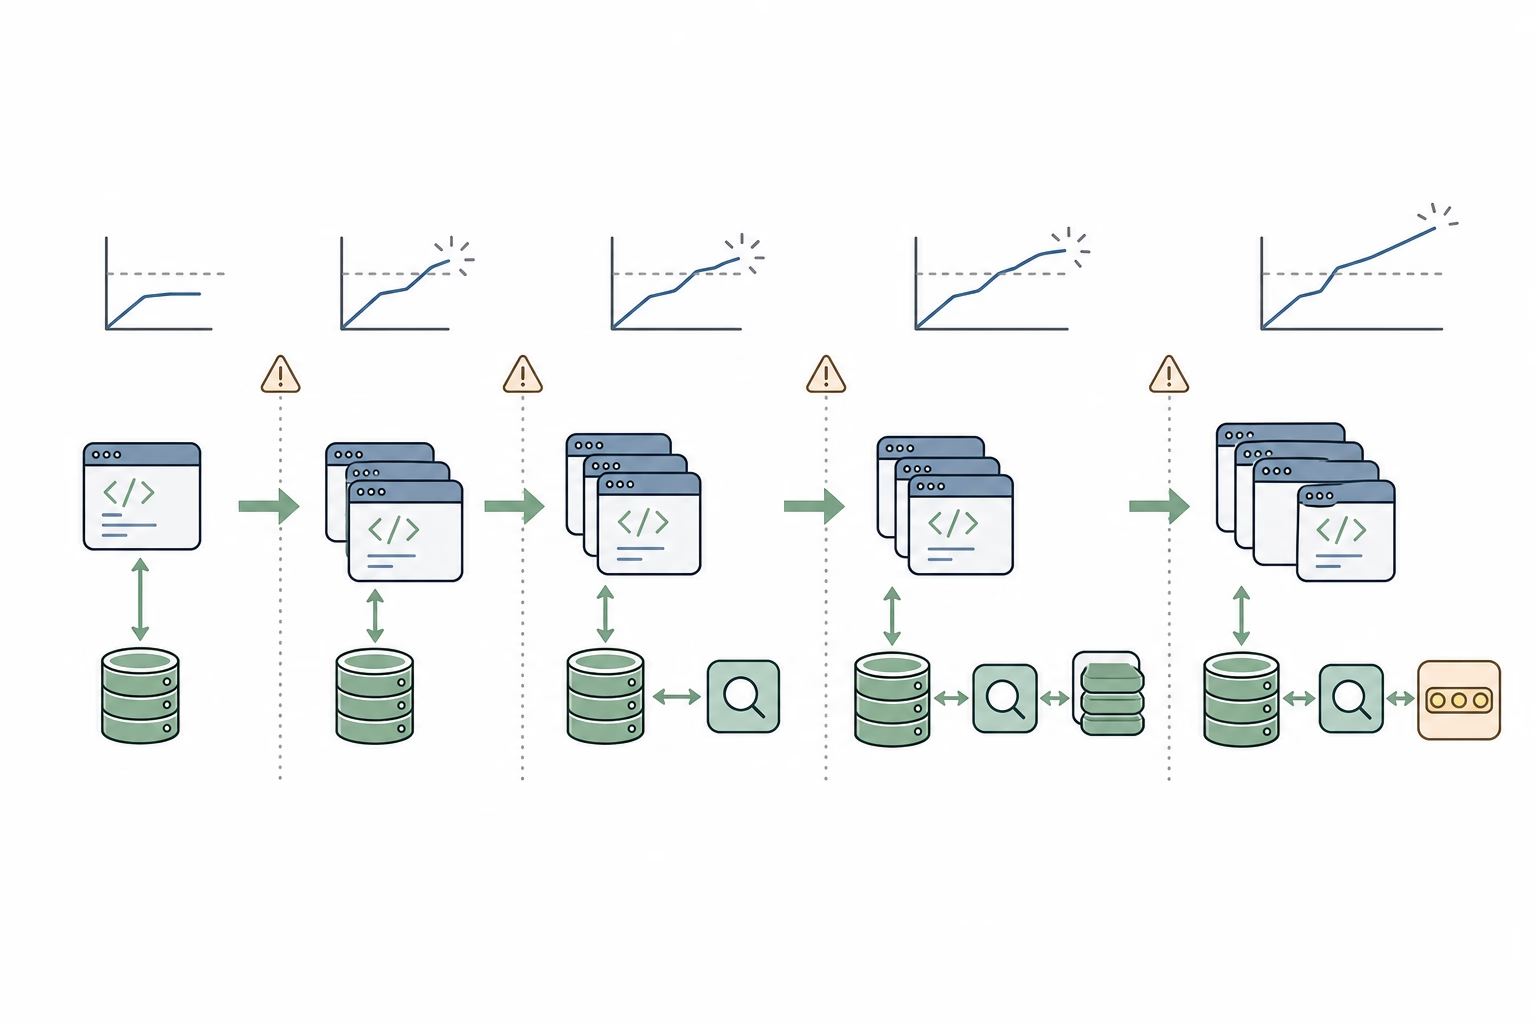
בשלב הזה אתם בטח חושבים: "זה נשמע כמו כמות מוגזמת של כלים ותשתיות רק כדי לבנות Agent פשוט. תורי Kafka, אינדקסים, Elasticsearch, מנגנוני זהויות, אבטחה... מאיפה בכלל מתחילים בלי לטבוע במורכבות?"
החדשות הטובות הן שלא צריך לבנות את כל זה ביום הראשון. אתם ממש לא צריכים Kafka, Elasticsearch או Redis כדי להעלות את ה-Agent הראשון שלכם לאוויר. למעשה, להתחיל עם כל התשתיות האלו בבת אחת זו דרך בטוחה לתקוע את הפרויקט.
מתחילים מהמערכת השלמה הקטנה ביותר שעובדת: Webhook Receiver פשוט ומסד נתונים יחיד של PostgreSQL. מוסיפים תשתיות נוספות רק כאשר מגיעים למגבלת ביצועים מדודה.
חושפים ל-Agent כלים צרים
ה-Agent לא צריך לדעת איזה ספק, מסד נתונים או אינדקס משרתים את הבקשה. תנו לו כלי Domain קטנים:
findContact: פותר אימייל, טלפון או Source Identity ל-Contact קנוניlistContactMessages: מחזיר עמוד כרונולוגי של הודעותsearchMessages: מחפש טקסט בתוך Tenant, Contact, Account או טווח זמן
כל תשובה צריכה לכלול Continuation Cursor, טריות ומזהי מקור.
טעויות בשכבה 1 שיוצרות Context גרוע
חמש טעויות פשוטות שהורסות ל-Agent את ה-Context:
1. דאטה של ספקים מלכלך את בסיס הנתונים
אם שמות העמודות בטבלאות שלכם נקראים לפי תגיות של Gmail או מזהים של Slack, חיבור של WhatsApp ישבור לכם את כל המוצר. שמרו את ה-JSON הגולמי לדיבאג, אבל תרגמו שדות זרים למודל נקי שלכם לפני ששאר המערכת נוגעת בהם.
2. ניחושים בחיבור זהויות
לעולם אל תאחדו אנשי קשר רק כי לשניהם קוראים "ג׳אנט". אנשים חולקים שמות תצוגה, מחליפים מספרי טלפון ומעדכנים כתובות אימייל. תאחדו רשומות רק לפי מזהים מאומתים, ואם יש ספק, תשאירו אותם מופרדים.
3. חיתוך היסטוריית שיחות
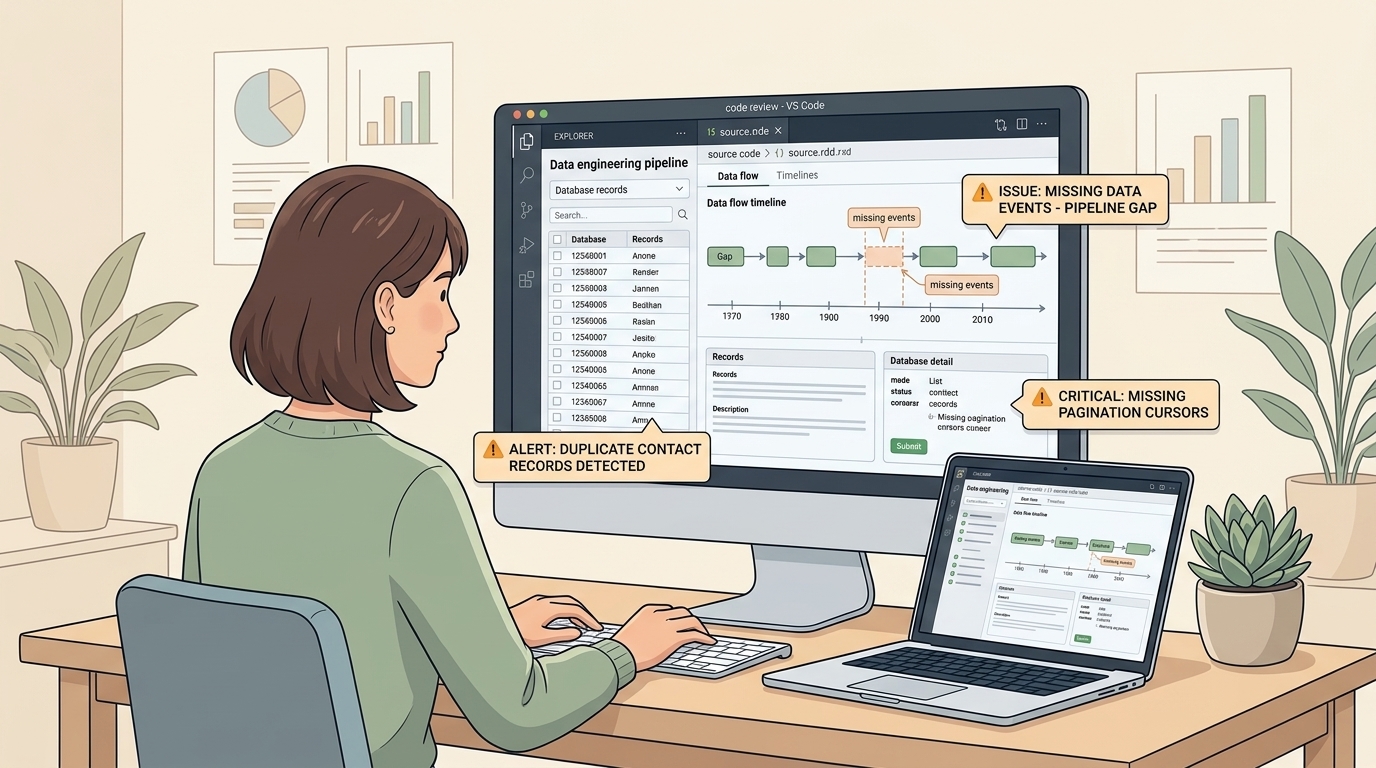
אם תגבילו שאילתות ל-20 הודעות בלי Pagination, ה-Agent יפספס את ההקשר הישן וימציא תשובות כי מבחינתו שאר השיחה מעולם לא התקיימה. כל שאילתת רשימה חייבת Cursor ואינדקס תואם.
4. בליעת שגיאות סנכרון
כאשר Webhook נכשל בשקט, ה-Agent עונה למשתמש "ג׳אנט מעולם לא הגיבה", בזמן שבפועל סנכרון המיילים קרס לפני שעה. שמרו אירועים שנכשלו יחד עם פרטי השגיאה, ונטרו את טריות הדאטה כדי שה-Agent יידע מתי מידע עדיין לא הגיע.
5. הנדסת יתר מהיום הראשון
אל תרימו Kafka, Elasticsearch ו-Redis לפני שיש לכם משתמשים אמיתיים. PostgreSQL מתמודד מצוין עם ישויות, ציר זמן וחיפוש בסיסי. תוסיפו מערכות מורכבות רק אחרי שמדידות יוכיחו שיש צוואר בקבוק אמיתי.
חוזרים לחידוש של ג׳אנט
המשתמש מבקש: "תביא לי את כל התקשורת עם janet@example.com על הצעת החידוש."
שכבה 1 מטפלת בבקשה בשלוש פעולות מוגבלות:
findContactפותר את האימייל ל-Contact ID קנוניsearchMessagesמחפש "הצעת חידוש" בתוך הרשומות של ג׳אנט- הכלי מחזיר עמוד אחד עם Lineage, טריות ו-Cursor
ה-Agent מקבל רשומות מכמה ספקים דרך Contract אחד. הוא לא מתרגם סכמות ולא מנחש אם הרשומות שייכות לאותה אישה.
מודל ההפעלה של שכבה 1
שכבה 1 אינה אוסף אינטגרציות. היא ה-Contract התפעולי המשותף למוצר ול-Agent.
הכלל של שכבה 1: קלטו דאטה לפני השיחה, פתרו זהויות פעם אחת, שמרו Authorization ו-Lineage, וענו לכל שאלה דרך כלי מוגבל ומאונדקס. השתמשו בקריאה חיה לספק רק כאשר דרישת הטריות מחייבת זאת.
המשיכו ל-חלק 5: ניהול Context אנליטי כדי לראות איך מטריקות מנוהלות נותנות ל-Agent ראיות כמותיות בלי להסתיר אי ודאות או מדיניות עסקית.
Context Layer
הירשמו לעדכונים על מאמרים חדשים
קבלו הודעה ישירות לתיבת הדוא"ל בכל פעם שמתפרסם ניתוח מוזיקלי או פרויקט AI חדש.
פרויקטים נוספים שאולי תאהבו
איך אני עובד עם AI בפיתוח תוכנה
פיתוח תוכנה עם AI הוא לא להאציל משימות לפרומפט. הוא עוסק בהסטת הפוקוס מכתיבת סינטקס למפרטים מפורטים, קריאת קוד, Context Layer ולולאות משוב מהירות.
Context Layer #1: למה ה-Agent שלך נכשל
בבסיסם, AI Agents הם פשוט לולאת LLM העטופה ב-Context וב-Tools. גלה למה ה-Context Layer הוא צוואר הבקבוק האמיתי של ביצועי Agent, ולמה איכות ה-Context חשובה בהרבה מ-Planning אוטונומי.
Context Layer #2: Evals, Evals, Evals
לפני שנכנסים לבניית Data Pipelines או Context Abstractions מורכבים, חייבים לענות על שאלה אחת מרכזית: איך מודדים מה באמת אפקטיבי? גלה את 4 רמות ה-Evals לבניית Context Layer מונחה ביצועים.